Embeddings e bancos de dados vetoriais
O que são embeddings, como bancos de dados vetoriais buscam por significado, as métricas de distância e como tudo isso se junta no RAG.
Neste artigo21 seções
- Embeddings
- O que é um vetor?
- Embeddings e vetores são a mesma coisa?
- Tipos de embeddings
- Como os embeddings são criados?
- Como funcionam os embeddings?
- Aplicações
- Desafios e limitações
- Bancos de dados vetoriais
- Como ele é diferente de um banco tradicional
- Métricas de distância
- Similaridade cosseno (cosine similarity)
- Produto escalar (dot product)
- Distância euclidiana (euclidean distance)
- Qual usar?
- Embeddings e bancos vetoriais no RAG
- Por que o RAG existe
- Como funciona
- Banco vetorial x RAG
- Melhorando a recuperação
- Referências
Este artigo junta duas peças que andam sempre juntas em aplicações de IA: os embeddings, que transformam dados em números, e os bancos de dados vetoriais, que guardam e buscam esses números. No fim, as duas se encontram no RAG.
Embeddings
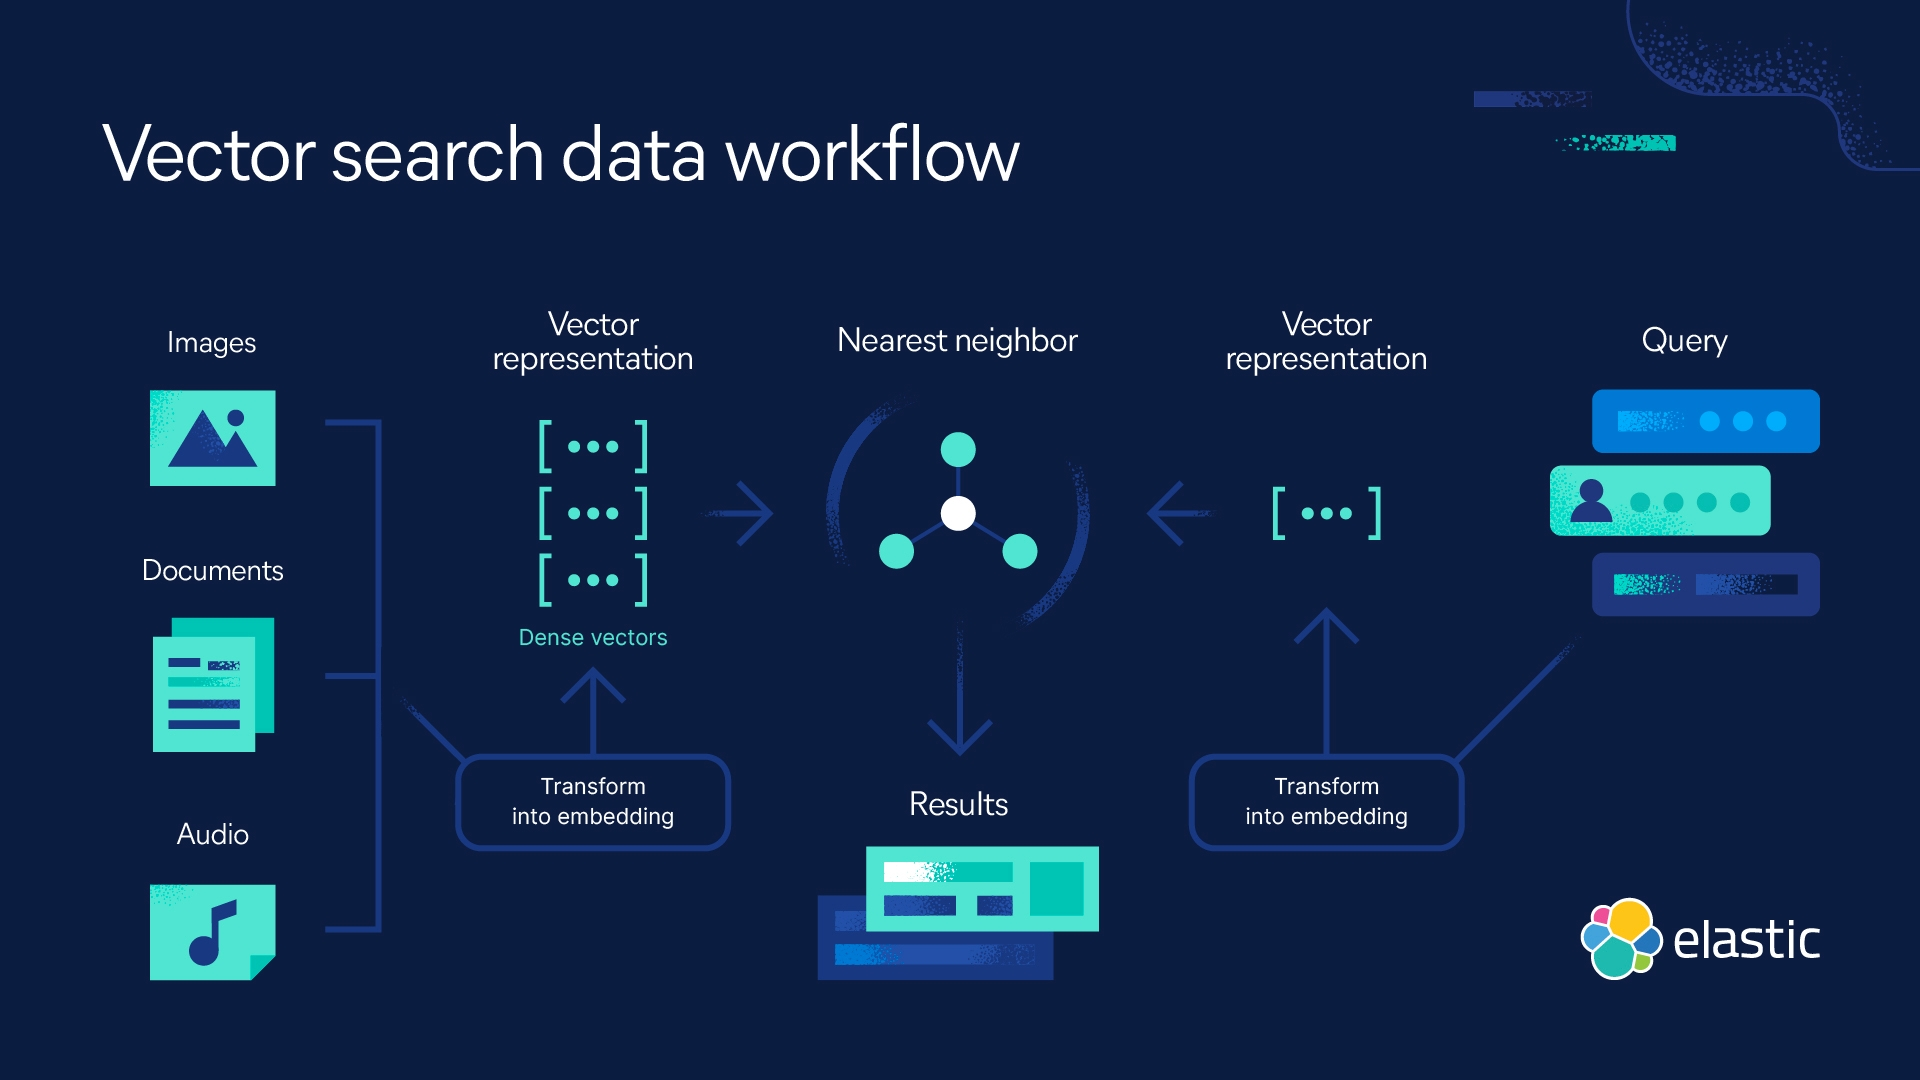
Embeddings são representações de valores ou objetos, como texto, imagens e áudio, que foram projetados para serem consumidos por modelos de aprendizado de máquina e algoritmos de pesquisa semântica.
Alguns embeddings podem representar documentos inteiros, e existem também vetores de imagem projetados para combinar conteúdo visual, vetores de perfil de usuário para entender as preferências de alguém, vetores de produto que ajudam a identificar produtos similares e muitos outros.
O que é um vetor?
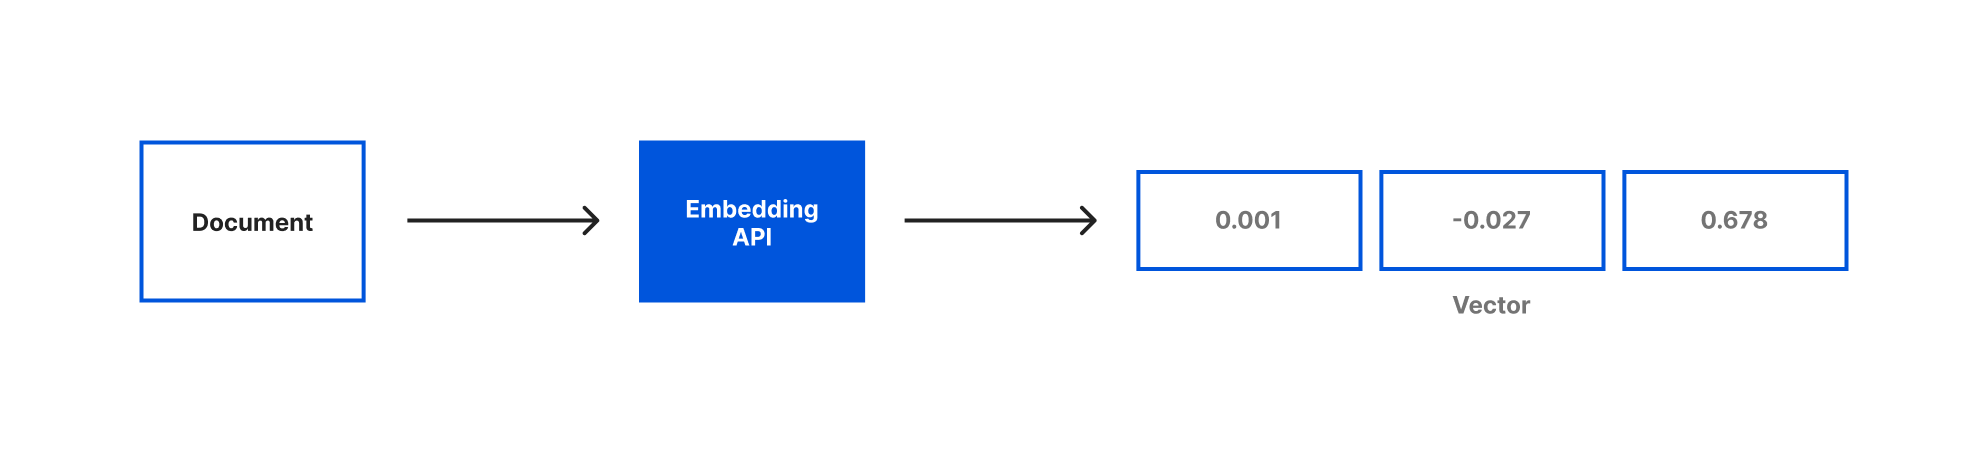
Um vetor é uma lista de números, como {1989, 22, 9, 180}. Cada número indica onde o objeto está em uma dimensão específica.
No aprendizado de máquina, o uso de vetores possibilita a busca de objetos semelhantes. Um algoritmo de busca de vetores simplesmente precisa encontrar dois vetores que estejam próximos em um banco de dados vetorial.
Para entender isso melhor, pense em latitude e longitude. Essas duas dimensões, norte-sul e leste-oeste, podem indicar a localização de qualquer lugar na Terra. A cidade de Vancouver, no Canadá, pode ser representada pelas coordenadas {49°15'40"N, 123°06'50"W}. Essa lista de dois valores é um vetor simples.
Imagine tentar encontrar uma cidade que seja muito próxima de Vancouver. Uma pessoa simplesmente olharia para um mapa, enquanto um modelo de aprendizado de máquina poderia olhar para a latitude e a longitude (ou vetor) e encontrar um local com valores semelhantes. A cidade de Burnaby fica em {49°16'N, 122°58'W}, muito próxima de {49°15'40"N, 123°06'50"W}. Portanto, o modelo pode concluir, corretamente, que Burnaby está localizada perto de Vancouver.
Embeddings e vetores são a mesma coisa?
No contexto de aprendizado de máquina, vetores e embeddings referem-se a representações numéricas de dados, mas com nuances distintas:
- Vetor: é simplesmente uma sequência ordenada de números. Por exemplo, o ponto (2, 3) em um gráfico bidimensional é um vetor com duas dimensões.
- Embedding: é uma técnica específica que transforma dados complexos (como palavras, imagens ou sons) em vetores de números reais. Esses vetores são projetados para capturar características significativas dos dados, como relações semânticas ou contextuais.
Em resumo, todos os embeddings são vetores, mas nem todos os vetores são embeddings. Os embeddings são vetores criados especificamente para representar dados de maneira significativa em modelos de aprendizado de máquina.
Tipos de embeddings
Palavras
Representam palavras individuais como vetores. Técnicas como Word2Vec, GloVe e FastText aprendem embeddings de palavras capturando relações semânticas e informações contextuais de textos.
Frases
Representam frases inteiras como vetores. Modelos como Universal Sentence Encoder (USE) e SkipThought geram embeddings que capturam o significado geral e o contexto das frases.
Documentos
Representam documentos, artigos, trabalhos acadêmicos e livros como vetores. Eles capturam as informações semânticas e o contexto de todo o documento. Técnicas como Doc2Vec e Paragraph Vectors foram projetadas para aprender embeddings de documentos.
Imagens
Representam imagens como vetores capturando diferentes características visuais. Técnicas como redes neurais convolucionais (CNNs) e modelos pré-treinados como ResNet e VGG geram embeddings de imagens para tarefas como classificação, detecção de objetos e similaridade de imagens.
Usuários
Representam usuários como vetores, capturando preferências, comportamentos e características. Os embeddings de usuários podem ser usados em tudo, desde sistemas de recomendação até marketing personalizado e segmentação de usuários.
Produtos
Representam produtos em e-commerce ou sistemas de recomendação como vetores. Eles capturam os atributos, recursos e qualquer outra informação semântica disponível de um produto. Os algoritmos podem então usar esses embeddings para comparar, recomendar e analisar produtos com base em suas representações vetoriais.
Como os embeddings são criados?
Os embeddings são criados por meio de um processo de machine learning no qual um modelo é treinado para converter os dados (imagens, textos e etc) em vetores numéricos, seguindo os passos:
- Dados: reunir um conjunto de dados representando o conteúdo que se deseja transformar em embeddings.
- Pré-processamento: limpar e preparar os dados, removendo ruídos, normalizando textos, redimensionando imagens e o que mais os dados exigirem.
- Modelo: selecionar o modelo de rede neural adequado para o tipo de dado com que se está trabalhando.
- Treinamento: o modelo aprende padrões e relações dentro dos dados ajustando seus parâmetros internos, aprendendo a associar palavras que aparecem juntas com frequência ou a reconhecer características visuais nas imagens.
- Aprendizado: ao aprender com os dados, o modelo gera os vetores numéricos (embeddings) que representam o significado ou as características de cada dado. Cada ponto, como uma palavra ou uma imagem, é representado por um vetor único.
- Validação: testando o modelo em tarefas específicas, é possível medir o quanto ele é eficaz em outros contextos.
Como funcionam os embeddings?
Os embeddings são o resultado desse processo: vetores gerados por redes neurais que depois são usados para pesquisas de similaridade.
Usando embeddings, um algoritmo pode sugerir um programa de TV relevante, encontrar locais semelhantes ou identificar quais palavras provavelmente serão usadas juntas ou são semelhantes umas às outras, como nos modelos de linguagem.
Embeddings que ficam próximos uns dos outros podem ser considerados semelhantes, assim como Burnaby e Vancouver têm valores de latitude e longitude próximos.
Já a dimensionalidade do vetor depende da técnica de embedding usada e de como os dados serão representados. Por exemplo, embeddings de palavras geralmente têm de algumas centenas a alguns milhares de dimensões, algo complexo demais para ser diagramado visualmente por humanos. Os embeddings de frases ou documentos podem ter dimensões maiores, porque capturam informações semânticas ainda mais complexas.
Aplicações
Mecanismos de busca
Motores de busca utilizam embeddings para compreender a intenção por trás das consultas dos usuários e fornecer resultados mais relevantes. Eles ajudam a identificar relações entre termos de pesquisa, corrigir erros de digitação, sugerir consultas relacionadas e recomendar conteúdos similares ao que o usuário procura.
Sistemas de recomendação
Embeddings são usados para entender as preferências dos usuários e as características dos itens, como produtos, filmes ou músicas. Com base nessa compreensão, os sistemas sugerem itens que provavelmente agradarão ao usuário, analisando a similaridade entre os interesses dele e os atributos dos itens disponíveis. Um exemplo é o sistema de recomendação da Netflix, que sugere filmes e séries com base no histórico de visualização.
Análise de imagens
Na área visual, embeddings permitem que algoritmos classifiquem imagens, identifiquem e detectem objetos, encontrem imagens semelhantes e organizem conteúdos visuais em categorias. Ferramentas como o Google Lens utilizam essa tecnologia para reconhecer e fornecer informações sobre objetos capturados em fotos.
Detecção de anomalias
Algoritmos podem usar embeddings para identificar padrões incomuns ou discrepantes em diversos tipos de dados. Treinando o sistema com dados que representam comportamentos normais, é possível detectar desvios que podem indicar atividades suspeitas ou problemas, o que é especialmente útil em segurança cibernética.
Desafios e limitações
- Palavras fora do vocabulário (OOV): modelos como o Word2Vec têm dificuldade com palavras que não viram durante o treinamento, resultando em representações inadequadas para termos desconhecidos. Modelos que quebram o texto em tokens menores que a palavra contornam boa parte desse problema.
- Escalabilidade para novos idiomas: adaptar embeddings para diferentes idiomas pode exigir novas matrizes de embedding, dificultando o compartilhamento de parâmetros entre línguas.
- Manutenção dos embeddings: configurar e manter bases de embeddings exige um bom entendimento dos modelos de aprendizado de máquina. Trocar o modelo, por exemplo, obriga a gerar todos os vetores de novo, já que vetores de modelos diferentes não são comparáveis entre si.
Bancos de dados vetoriais
Os bancos de dados vetoriais são uma parte fundamental da criação de aplicações escaláveis com IA. Sem um banco de dados vetorial, seria necessário reprocessar seus dados com o modelo toda vez que quisesse buscar ou comparar algo, o que tornaria o sistema lento e caro.
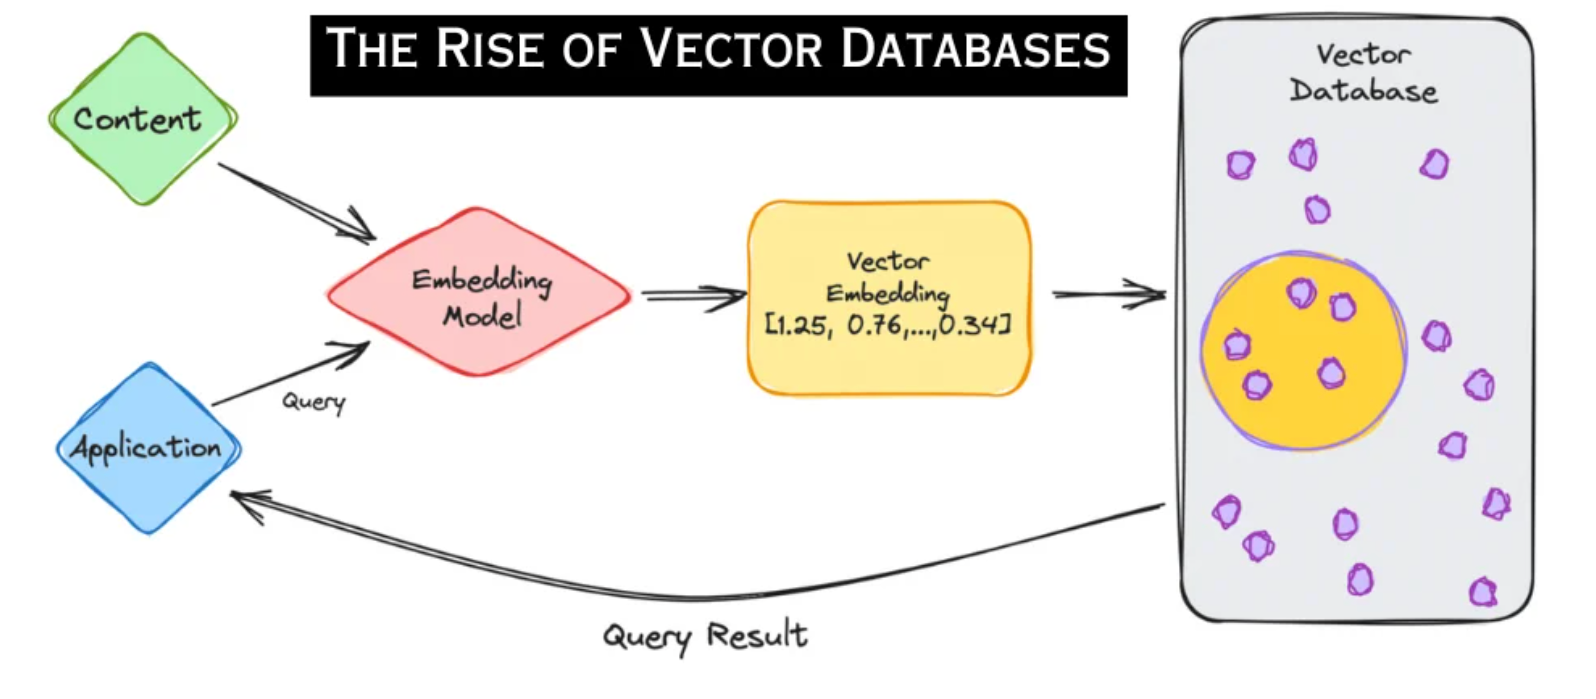
Os bancos de dados vetoriais armazenam os vetores (ou embeddings) gerados por modelos de machine learning. Esses vetores representam conteúdos como textos, imagens ou áudios em uma forma matemática que facilita buscas por similaridade semântica.
Ao realizar uma consulta, o banco determina quais dados representados como vetores estão perto da sua entrada, o que permite criar diferentes aplicações, como:
- Pesquisa semântica: retorna resultados semelhantes à consulta.
- Classificação: retorna o agrupamento mais próximo da consulta.
- Mecanismos de recomendação: retornam conteúdo semelhante à entrada com base em critérios diferentes (por exemplo, vendas de produtos anteriores ou histórico do usuário).
Além disso, podem ser utilizados para alimentar um RAG (Retrieval-Augmented Generation), trazendo contexto adicional para LLMs a partir de uma pesquisa vetorial que aumenta o prompt do usuário. Esse uso aparece mais abaixo.
Como ele é diferente de um banco tradicional
Em vez das linhas e colunas típicas de bancos de dados relacionais, os bancos de dados vetoriais representam dados como pontos em um espaço multidimensional. Eles são ideais para aplicações que precisam encontrar dados por similaridade, e não por valores exatos e estruturados.
Consultar um banco de dados vetorial também é diferente. Em vez de procurar correspondências exatas, o banco usa pesquisa de similaridade para identificar os vetores que estão mais próximos do vetor da consulta dentro desse espaço multidimensional. Essa abordagem combina mais com a natureza dos dados, como textos e imagens, onde "parecido" importa mais do que "igual".
Para dizer o que é "próximo", o banco precisa de uma forma de medir distância entre vetores. São as métricas de distância.
Métricas de distância
Similaridade cosseno (cosine similarity)
A similaridade cosseno é uma maneira de medir o quão parecidos dois vetores são. Ela mostra se os vetores apontam para a mesma direção (ou seja, se são parecidos) ou se apontam para lados opostos. É muito usada para comparar textos, como verificar o quanto duas frases ou documentos se parecem.
O resultado dessa comparação vai de -1 a 1, sendo:
- 1 = completamente parecidos (mesma direção)
- 0 = nada a ver (vetores em ângulo reto)
- -1 = totalmente opostos
Exemplo
Imagine que cada vetor seja uma seta apontando em uma direção. A similaridade cosseno mede o ângulo entre essas setas, ignorando o comprimento delas. Se as duas setas apontam para a mesma direção, bingo! Elas são super parecidas. É como comparar dois textos e ver que falam quase a mesma coisa, mesmo que um seja mais longo.
Produto escalar (dot product)
O produto escalar também mede a semelhança entre vetores, mas considera o tamanho deles, diferente da similaridade cosseno. Isso pode fazer diferença, especialmente quando os vetores representam coisas como a frequência de palavras em um texto.
Ele é calculado multiplicando os valores correspondentes dos vetores e somando os resultados. Quanto maior a soma, mais parecidos eles são.
Se você normalizar os vetores (deixar todos com comprimento igual a 1), o produto escalar passa a dar o mesmo resultado da similaridade cosseno.
Exemplo
Pense nos vetores como listas de números que representam algo, como quantas vezes cada palavra aparece em um texto. O produto escalar multiplica cada par de números (um de cada vetor) e soma tudo. Se os números são altos nos mesmos lugares, a soma fica grande, ou seja, os vetores são parecidos.
É como comparar duas receitas: se ambas usam muito açúcar, farinha e leite, a "soma das semelhanças" vai ser alta.
Distância euclidiana (euclidean distance)
A distância euclidiana mede o quão longe dois pontos estão um do outro em um espaço. É parecida com medir a distância entre dois lugares em um mapa.
Ela é calculada fazendo a raiz quadrada da soma das diferenças ao quadrado entre as coordenadas dos pontos. É muito usada em aprendizado de máquina para dizer se duas coisas são parecidas ou bem diferentes.
Exemplo
Imagine que os vetores sejam pontos num espaço tridimensional (ou com mais dimensões). A distância euclidiana é a régua que mede o caminho direto entre esses dois pontos. Quanto menor a distância, mais próximos (ou mais parecidos) eles são.
É como medir o quão longe estão dois jogadores em um mapa de videogame: quanto mais perto, mais "iguais" eles estão.
Qual usar?
Na prática, a métrica costuma seguir o modelo de embeddings. Cada modelo é treinado pensando em uma forma de comparação, e a documentação dele normalmente diz qual usar. Para embeddings de texto, a similaridade cosseno é a escolha mais comum.
Embeddings e bancos vetoriais no RAG
A Geração Aumentada por Recuperação (RAG) é uma técnica que aprimora os LLMs integrando-os a fontes de dados externas. Ao combinar a capacidade de gerar texto dos modelos com mecanismos precisos de recuperação de informações, o RAG permite que os sistemas de IA produzam respostas mais precisas e contextualmente relevantes.
É aqui que embeddings e bancos de dados vetoriais se encontram.
Por que o RAG existe
Os LLMs são poderosos, mas vêm com limitações:
- Conhecimento limitado: os LLMs só podem gerar respostas com base em seus dados de treinamento, que podem estar desatualizados ou não ter informações específicas do domínio.
- Alucinações: esses modelos às vezes geram informações plausíveis, mas incorretas.
- Respostas genéricas: sem acesso a fontes externas, os LLMs podem fornecer respostas vagas ou imprecisas.
O RAG aborda esses problemas permitindo que os modelos recuperem informações atualizadas e específicas de domínio de fontes de dados estruturadas e não estruturadas, como bancos de dados, documentação e APIs.
Como funciona
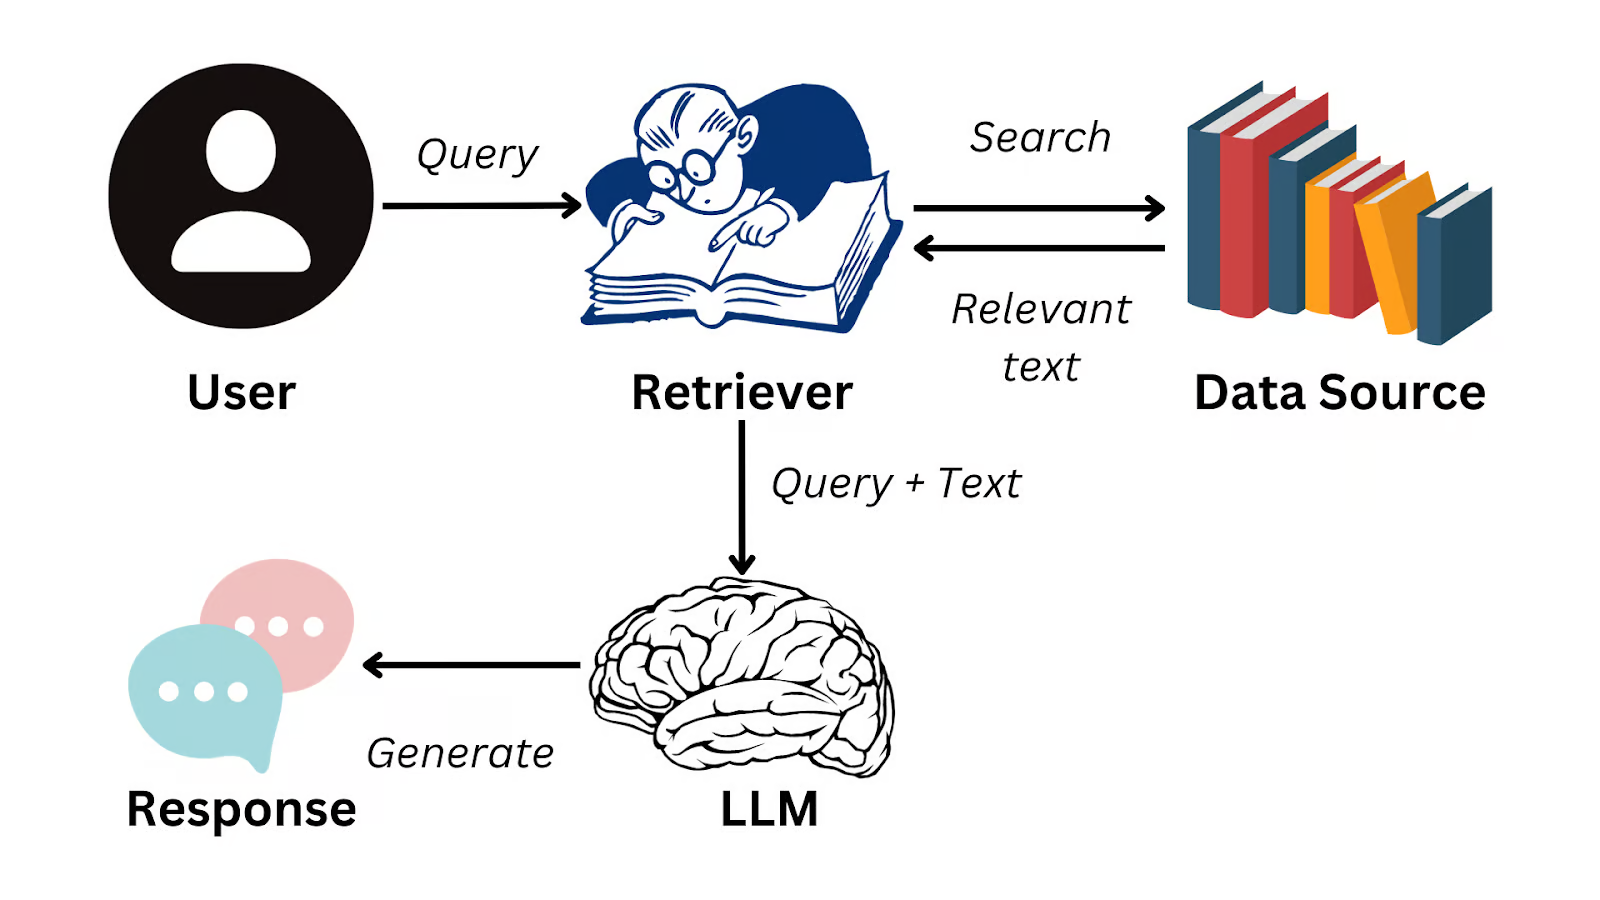
Coleta de dados
Primeiro são coletados todos os dados necessários para o contexto. No caso de um chatbot de suporte ao cliente para uma empresa de eletrônicos, isso pode incluir manuais de usuário, um banco de dados de produtos e uma lista de perguntas frequentes.
Processamento dos dados
A fragmentação (chunking) é o processo de dividir seus dados em partes menores e mais gerenciáveis. Por exemplo, se você tiver um manual de usuário de 100 páginas, poderá dividi-lo em seções diferentes, cada uma respondendo a perguntas de clientes diferentes.
Embeddings dos documentos
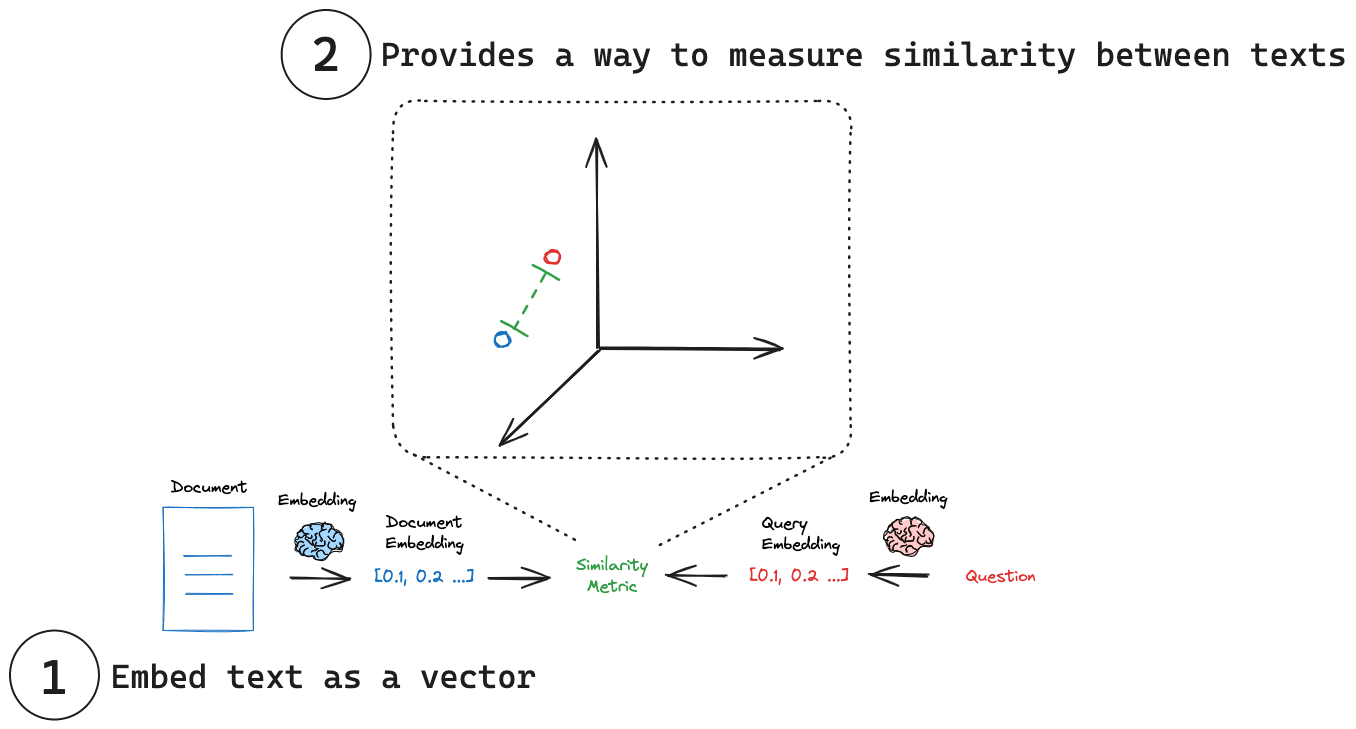
Cada pedaço de texto é transformado em embeddings, que são representações numéricas que capturam o significado por trás do texto, e guardado no banco de dados vetorial.
Em palavras simples, os embeddings permitem que o sistema compreenda as consultas do usuário e as combine com informações relevantes no conjunto de dados com base no significado do texto, de forma semântica, em vez de uma simples comparação palavra a palavra.
Tratando a consulta do usuário
Quando uma consulta de usuário entra no sistema, ela também precisa ser convertida em embedding. O mesmo modelo deve ser usado tanto para os documentos quanto para a consulta, para garantir que os vetores sejam comparáveis.
Uma vez convertida, o sistema compara o embedding da consulta com os embeddings dos documentos e recupera os pedaços mais semelhantes, usando medidas como a similaridade cosseno e a distância euclidiana.
Gerando a resposta com um LLM
Os pedaços de texto recuperados, junto com a consulta inicial do usuário, são enviados ao modelo. Ele usa essas informações para gerar uma resposta coerente para a pergunta do usuário.
O fluxo simplificado do RAG fica assim:
Banco vetorial x RAG
Embora um banco de dados vetorial seja uma ferramenta poderosa para armazenar e recuperar informações baseadas em similaridade, ele não possui, por si só, a capacidade de gerar respostas ou conteúdo.
O RAG utiliza bancos de dados vetoriais como parte do seu processo, recuperando informações relevantes que depois enriquecem a resposta gerada pelo LLM. Ou seja, o banco vetorial fornece o mecanismo de recuperação, e o RAG integra essa recuperação com a geração de texto, resultando em respostas mais informadas e contextuais.
Melhorando a recuperação
Buscar os pedaços mais parecidos com a pergunta funciona, mas tem custo: cada pedaço recuperado vira token no prompt, e nem sempre o que é parecido é o que é útil. Duas técnicas ajudam bastante.
Índice de resumos (Document Summary Index)
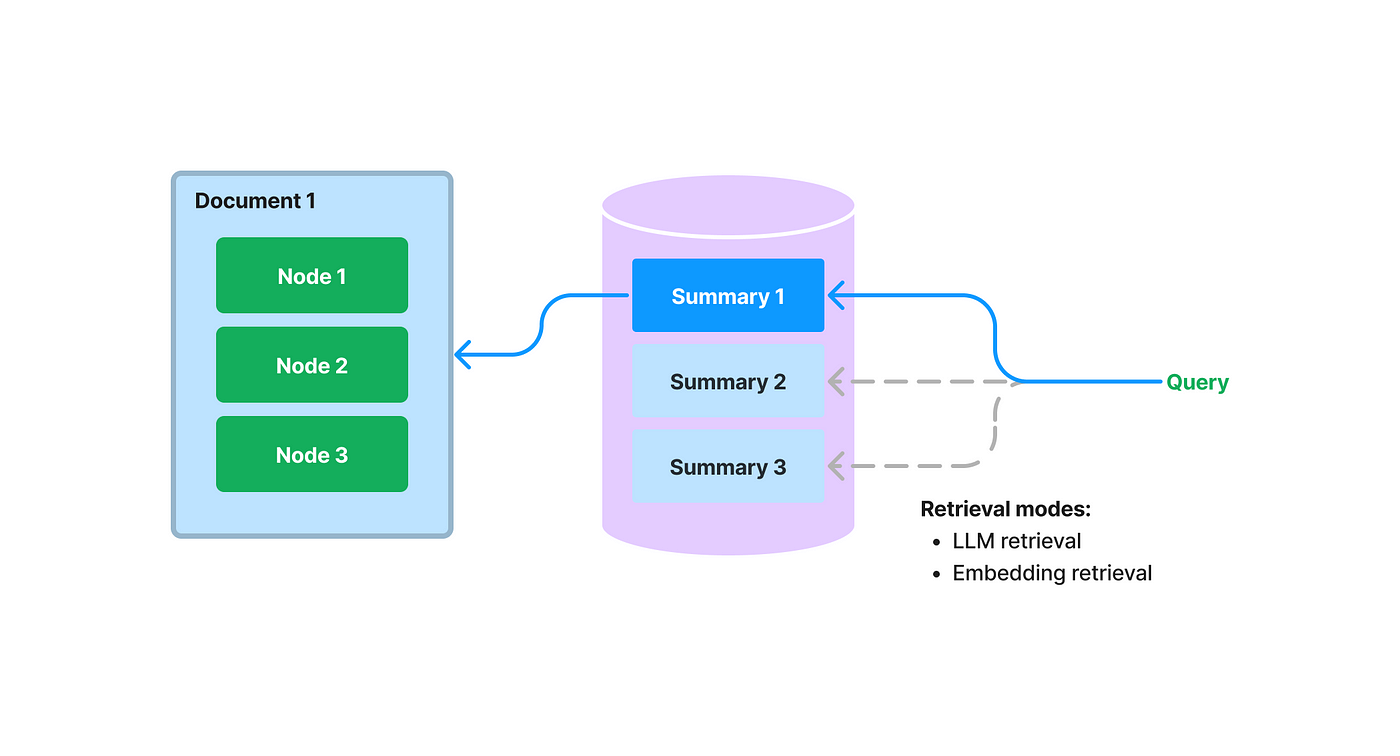
A ideia é criar um mini-resumo de cada documento assim que ele entra no pipeline do RAG, antes mesmo de ser vetorizado.
Um LLM destila cada arquivo numa versão de 5 a 10 vezes menor, esse resumo é gravado lado a lado com os pedaços originais e a primeira filtragem é feita usando só os resumos. A LlamaIndex chama isso de Document Summary Index, e a LangChain tem uma ideia parecida no MultiVector Retriever, que guarda o resumo como um vetor extra para cada documento.
Por que resumir?
- Corte brutal de tokens: só o que é essencial entra no índice de alto nível, reduzindo custo e latência nas próximas buscas.
- Busca mais certeira: primeiro o sistema compara o prompt do usuário com os resumos, curtos e fáceis de entender o tema. Depois, se o documento parece relevante, ele traz os pedaços reais para a resposta.
- Menos viés de top-k: como vários documentos cabem no corte inicial, a resposta não fica "presa" em um único PDF gigantesco.
Compressão contextual (Contextual Compression Retriever)
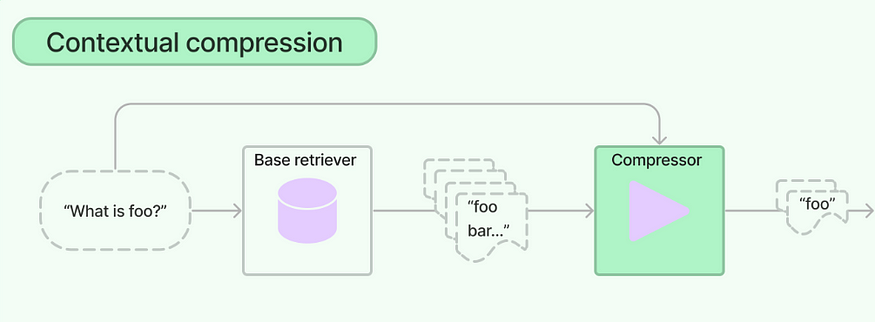
É um "recuperador com compressão". Diferente de um recuperador comum, que devolve o texto inteiro que foi armazenado, ele passa os documentos por um compressor, que pede a um LLM para manter só o que é realmente útil para a pergunta feita. Isso reduz tokens, melhora a precisão e, de quebra, acelera toda a etapa de geração.
As duas técnicas seguem a mesma linha: em vez de mandar mais contexto para o modelo, mandar o contexto certo. Para ir mais fundo em RAG, a série Engenharia de IA tem duas partes dedicadas ao assunto.
Referências
Este artigo vem das minhas notas de estudo, construídas a partir destes materiais:
- O que são embeddings?, Cloudflare
- O que é vector embedding?, Elastic
- What is a vector database?, Cloudflare
- Vector databases, MongoDB
- What is Retrieval Augmented Generation (RAG)?, DataCamp
- Document Summary Index, LlamaIndex
- Contextual compression, LangChain