De Sherlock ao GPT: a estatística por trás da linguagem
De Sherlock Holmes à entropia de Shannon: como a estatística da linguagem levou aos tokens e aos modelos de linguagem atuais.
Série · Parte 1 de 14 Engenharia de IA
- 01 De Sherlock ao GPT: a estatística por trás da linguagem 7 min
- 02 O que existe dentro de um modelo base 9 min
- 03 Parâmetros, computação e os limites da escala 8 min
- 04 Pós-treinamento e amostragem: por que a IA responde diferente a cada vez 9 min
- 05 Como medir um modelo: entropia, perplexidade e IA como juiz 10 min
- 06 Critérios de avaliação: sua IA realmente ajuda o negócio? 6 min
- 07 Escolhendo um modelo: API, código aberto e benchmarks 10 min
- 08 Do pipeline de avaliação ao primeiro prompt 11 min
- 09 Boas práticas de engenharia de prompt 9 min
- 10 RAG: dando contexto ao modelo 13 min
- 11 RAG na prática: otimizando a recuperação 9 min
- 12 Agentes: ferramentas e planejamento 13 min
- 13 Agentes: execução, falhas e memória 12 min
- 14 Arquitetura de uma aplicação de IA 11 min
Neste artigo11 seções
ChatGPT, Gemini, Claude e todos os outros modelos que usamos hoje têm uma origem bem mais antiga do que parece. Eles descendem dos modelos de linguagem, uma ideia que começou a ganhar forma lá pela década de 1950.
Um modelo de linguagem, na sua forma mais simples, é um algoritmo que tenta prever qual é a próxima palavra de uma frase. Ele faz isso olhando quantas vezes, nos textos que viu durante o treinamento, uma palavra apareceu depois da outra.
Se eu escrevo "Minha cor favorita é ___", o modelo sabe que "azul" é uma continuação muito mais provável do que "carro". Não porque ele entende o que é uma cor, mas porque, estatisticamente, "azul" aparece muito mais vezes nesse tipo de frase.
Essa é a base de tudo que vem depois nesta série.
A natureza estatística dos idiomas
A ideia de que a língua segue padrões estatísticos não é nova. Ela aparece até na ficção.
Sherlock e os homens dançantes
No conto "The Adventure of the Dancing Men" (A aventura dos homens dançantes), de 1905, Sherlock Holmes recebe uns desenhos de bonequinhos que parecem estar dançando. Não são rabiscos de criança: são um código usado para esconder mensagens.
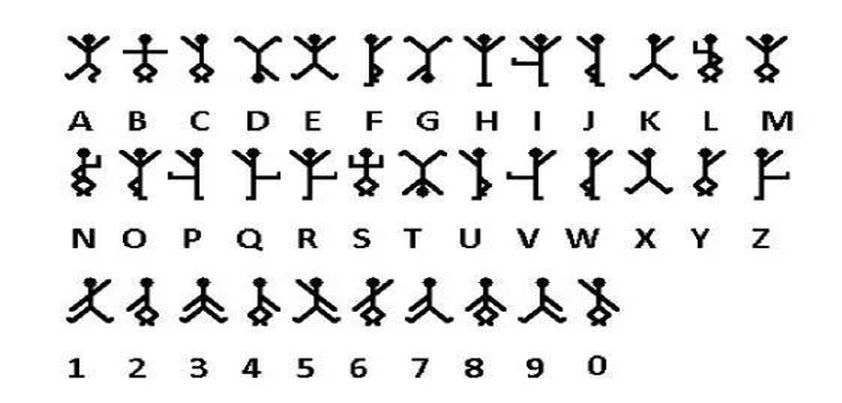
Sherlock percebeu que alguns símbolos se repetiam muito mais do que outros. Então ele assumiu que os símbolos mais frequentes deveriam corresponder às letras mais frequentes do inglês, como E, T e A.
Com essa contagem ele começou a montar um mapa de símbolo para letra. Depois que alguns pares estão certos, o resto vai se encaixando. A última mensagem que ele decifra é "ELSIE PREPARE TO MEET THY GOD", um aviso de perigo que faz Holmes agir na hora.
Claude Shannon e a entropia
Décadas depois, Claude Shannon usou estatística bem mais sofisticada para decifrar mensagens inimigas durante a Segunda Guerra Mundial. E foi além: ele formalizou uma forma de medir o quanto uma fonte de informação é imprevisível.
H(X) = − Σ p(x) · log p(x)
Aqui, p(x) é a probabilidade de cada símbolo aparecer (letras, espaços, etc.). A fórmula calcula uma média ponderada da surpresa, ou seja, o quanto você espera estar incerto ao ver o próximo símbolo.
Esse valor é a entropia:
- Quando algo é previsível, a entropia é baixa.
- Quando é muito imprevisível, a entropia é alta.
Pense numa moeda normal, com cara e coroa. Cada lado tem 50% de chance, você não tem como saber o que vai sair, então a entropia é alta. Agora imagine uma moeda com cara dos dois lados. Toda vez que você jogar vai dar cara. Ela é totalmente previsível, então a entropia é baixa.
Em modelos de linguagem, a entropia mede quanta informação, em média, cada token carrega. Quanto maior a entropia, mais informação cada token carrega e mais bits são necessários para representá-lo.
Shannon pegou essa ideia e aplicou numa língua real, o inglês, para medir o quanto ela é previsível. E mostrou que o inglês não é um amontoado de letras aleatórias: ele tem regras, dependências e padrões.
Com isso dava para quantificar coisas como:
- Quanta informação um texto realmente tem.
- Qual é o limite teórico para comprimir um texto sem perder nada.
- Quanta incerteza existe antes de você ver o próximo símbolo.
Esse trabalho influenciou telecomunicações e compressão de dados, e virou uma das bases do processamento de linguagem natural e dos modelos de linguagem estatísticos, que estão em tudo, desde o corretor ortográfico até os sistemas de IA atuais.
A grande virada de chave é essa: transmitir uma mensagem deixa de ser só decodificar o que vem a seguir e passa a ser reduzir incerteza.
Tokens
A unidade básica de um modelo de linguagem é o token. Um token pode ser um caractere, uma palavra inteira ou um pedaço de palavra, depende do modelo. Cada modelo quebra o texto do seu jeito.
Você pode ver como os modelos da OpenAI dividem um texto no Tokenizer da OpenAI. Na imagem abaixo, cada cor é um token:
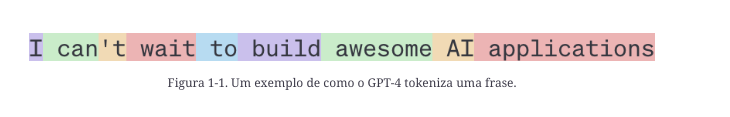
Esse processo de quebrar o texto em tokens se chama tokenização. No GPT-4, um token tem em média uns ¾ do tamanho de uma palavra. Então 100 tokens dão mais ou menos 75 palavras.
O conjunto de todos os tokens que um modelo conhece é o seu vocabulário. Com poucos tokens dá para montar muitas palavras diferentes, do mesmo jeito que com 26 letras você escreve qualquer palavra do idioma.
Por que não usar palavras inteiras?
Quebrar palavras em pedaços ajuda o modelo a reaproveitar significado. "Cooking" pode virar "cook" e "ing", e cada parte carrega um pedaço do sentido original.
Também ajuda com palavras que não existem no vocabulário. Se alguém escreve "chatgpting", o modelo pode quebrar em "chatgpt" e "ing" e entender a estrutura, mesmo nunca tendo visto essa palavra.
O token fica no meio do caminho: são menos unidades do que palavras inteiras, mas carregam muito mais significado do que letras soltas.
Tipos de modelos de linguagem
Existem dois tipos principais, e a diferença está em quais informações eles usam para prever um token.
Modelo de linguagem mascarado (MLM)
É treinado para prever tokens que estão faltando em qualquer lugar da frase, usando o que vem antes e depois do espaço vazio.
É como preencher lacunas. Dado "Meu ___ favorito é azul", o modelo deve prever que o espaço provavelmente é "cor".
O exemplo mais conhecido é o BERT (Bidirectional Encoder Representations from Transformers), do Google, treinado justamente escondendo partes do texto e aprendendo a adivinhá-las pelo contexto completo.
Pense na palavra "banco". Para saber se é um lugar para sentar ou uma instituição financeira, você precisa olhar o que vem antes e depois. Esse tipo de modelo é bom exatamente nisso.
Por isso ele é mais usado em tarefas que não geram texto, como análise de sentimento e classificação. Também funciona bem em tarefas que precisam entender o contexto inteiro, como depurar código, onde o modelo precisa ver o que vem antes e depois de um trecho para achar o erro.
Modelo de linguagem autorregressivo
É treinado para prever o próximo token usando apenas os tokens anteriores. Ele completa "Minha cor favorita é ___".
Como ele sempre olha para trás e gera o próximo, consegue gerar um token atrás do outro sem parar. Por isso é o modelo preferido para geração de texto e é bem mais popular hoje do que o mascarado.
- Você escreve: "Eu gosto de comer"
- O modelo tenta prever a palavra mais provável a seguir: "pizza", "maçã", etc.
Resumindo de um jeito simples:
- Mascarado: entende o contexto completo.
- Autorregressivo: produz o próximo passo com base no que já veio.
Autossupervisão
Um ponto que fez os modelos de linguagem crescerem tanto é o aprendizado autossupervisionado. O modelo aprende direto das sequências de texto, sem ninguém precisar rotular nada.
Pense: se o objetivo é prever a próxima palavra, o próprio texto já é a resposta. Qualquer frase de um livro, post de blog, artigo ou comentário no Reddit vira um exemplo de treino. Como texto existe em todo lugar, dá para montar uma quantidade enorme de dados, e foi isso que permitiu que esses modelos crescessem até virar os LLMs (Large Language Models).
O que é "grande"?
LLM não é um termo científico. Qual o tamanho para um modelo ser considerado grande? O que é grande hoje pode ser pequeno amanhã.
Normalmente o tamanho é medido pelo número de parâmetros:
- O primeiro GPT da OpenAI, em junho de 2018, tinha 117 milhões de parâmetros, e isso era considerado grande.
- Em fevereiro de 2019 veio o GPT-2 com 1,5 bilhão, e os 117 milhões passaram a ser pequenos.
- Hoje um modelo com 100 bilhões de parâmetros é considerado grande. Talvez um dia não seja mais.
E por que modelos maiores precisam de mais dados? Porque eles têm mais capacidade de aprender, então precisam de mais exemplos para aproveitar essa capacidade. Até dá para treinar um modelo grande com poucos dados, mas é desperdício de computação: um modelo menor chegaria num resultado parecido ou melhor.
No próximo artigo eu entro no que existe dentro de um desses modelos: os dados usados no treinamento, a arquitetura transformer e o tal do contexto.
Referência
Este artigo faz parte dos meus estudos sobre engenharia de IA, baseados no livro AI Engineering: Building Applications with Foundation Models, de Chip Huyen (O'Reilly, 2025). As imagens usadas aqui também vêm do livro.