Pós-treinamento e amostragem: por que a IA responde diferente a cada vez
Como o modelo é ajustado para conversar e como temperatura, top-k e top-p explicam inconsistências e alucinações.
Série · Parte 4 de 14 Engenharia de IA
- 01 De Sherlock ao GPT: a estatística por trás da linguagem 7 min
- 02 O que existe dentro de um modelo base 9 min
- 03 Parâmetros, computação e os limites da escala 8 min
- 04 Pós-treinamento e amostragem: por que a IA responde diferente a cada vez 9 min
- 05 Como medir um modelo: entropia, perplexidade e IA como juiz 10 min
- 06 Critérios de avaliação: sua IA realmente ajuda o negócio? 6 min
- 07 Escolhendo um modelo: API, código aberto e benchmarks 10 min
- 08 Do pipeline de avaliação ao primeiro prompt 11 min
- 09 Boas práticas de engenharia de prompt 9 min
- 10 RAG: dando contexto ao modelo 13 min
- 11 RAG na prática: otimizando a recuperação 9 min
- 12 Agentes: ferramentas e planejamento 13 min
- 13 Agentes: execução, falhas e memória 12 min
- 14 Arquitetura de uma aplicação de IA 11 min
Neste artigo16 seções
- Pós-treinamento
- Dados de demonstração
- A importância de bons rotuladores
- Amostragem
- Como o modelo escolhe uma resposta
- Amostragem gananciosa
- Logits
- Estratégias de amostragem
- Temperatura
- Top-k
- Top-p
- Condição de parada
- A natureza probabilística da IA
- Inconsistência
- Como reduzir a inconsistência
- Referência
Depois do pré-treinamento, o modelo já sabe muita coisa, mas ainda não está pronto para conversar com ninguém. Neste artigo eu falo de duas etapas que explicam boa parte do comportamento que vemos no dia a dia: o pós-treinamento, que ensina o modelo a interagir com pessoas, e a amostragem, que é como ele escolhe cada palavra da resposta.
Pós-treinamento
Um modelo base que acabou de sair do pré-treinamento tem dois problemas.
O primeiro: como os dados de treinamento vêm de todo canto da internet, ele pode reproduzir comportamentos racistas, sexistas, grosseiros ou simplesmente errados.
O segundo: ele não sabe que está numa conversa. Se você perguntar "como faço uma pizza?", ele pode só continuar a frase, como se estivesse completando um texto, em vez de responder.
O pós-treinamento existe para resolver essas duas coisas e alinhar o modelo ao que as pessoas esperam dele. Se quiser ler mais, a OpenAI tem um material sobre isso em Aligning language models to follow instructions.
Dados de demonstração
Como o modelo imita os dados com que foi treinado, a forma de ensinar ele a responder é mostrar exemplos de boas respostas. Esses exemplos seguem o formato (prompt, resposta) e são chamados de dados de demonstração.
Tem gente que chama esse processo de clonagem de comportamento: você demonstra como o modelo deve se comportar e ele copia.
Como cada tipo de pedido pede um tipo de resposta, os exemplos precisam cobrir a variedade de tarefas que você quer que o modelo saiba fazer: responder perguntas, resumir, traduzir, etc.
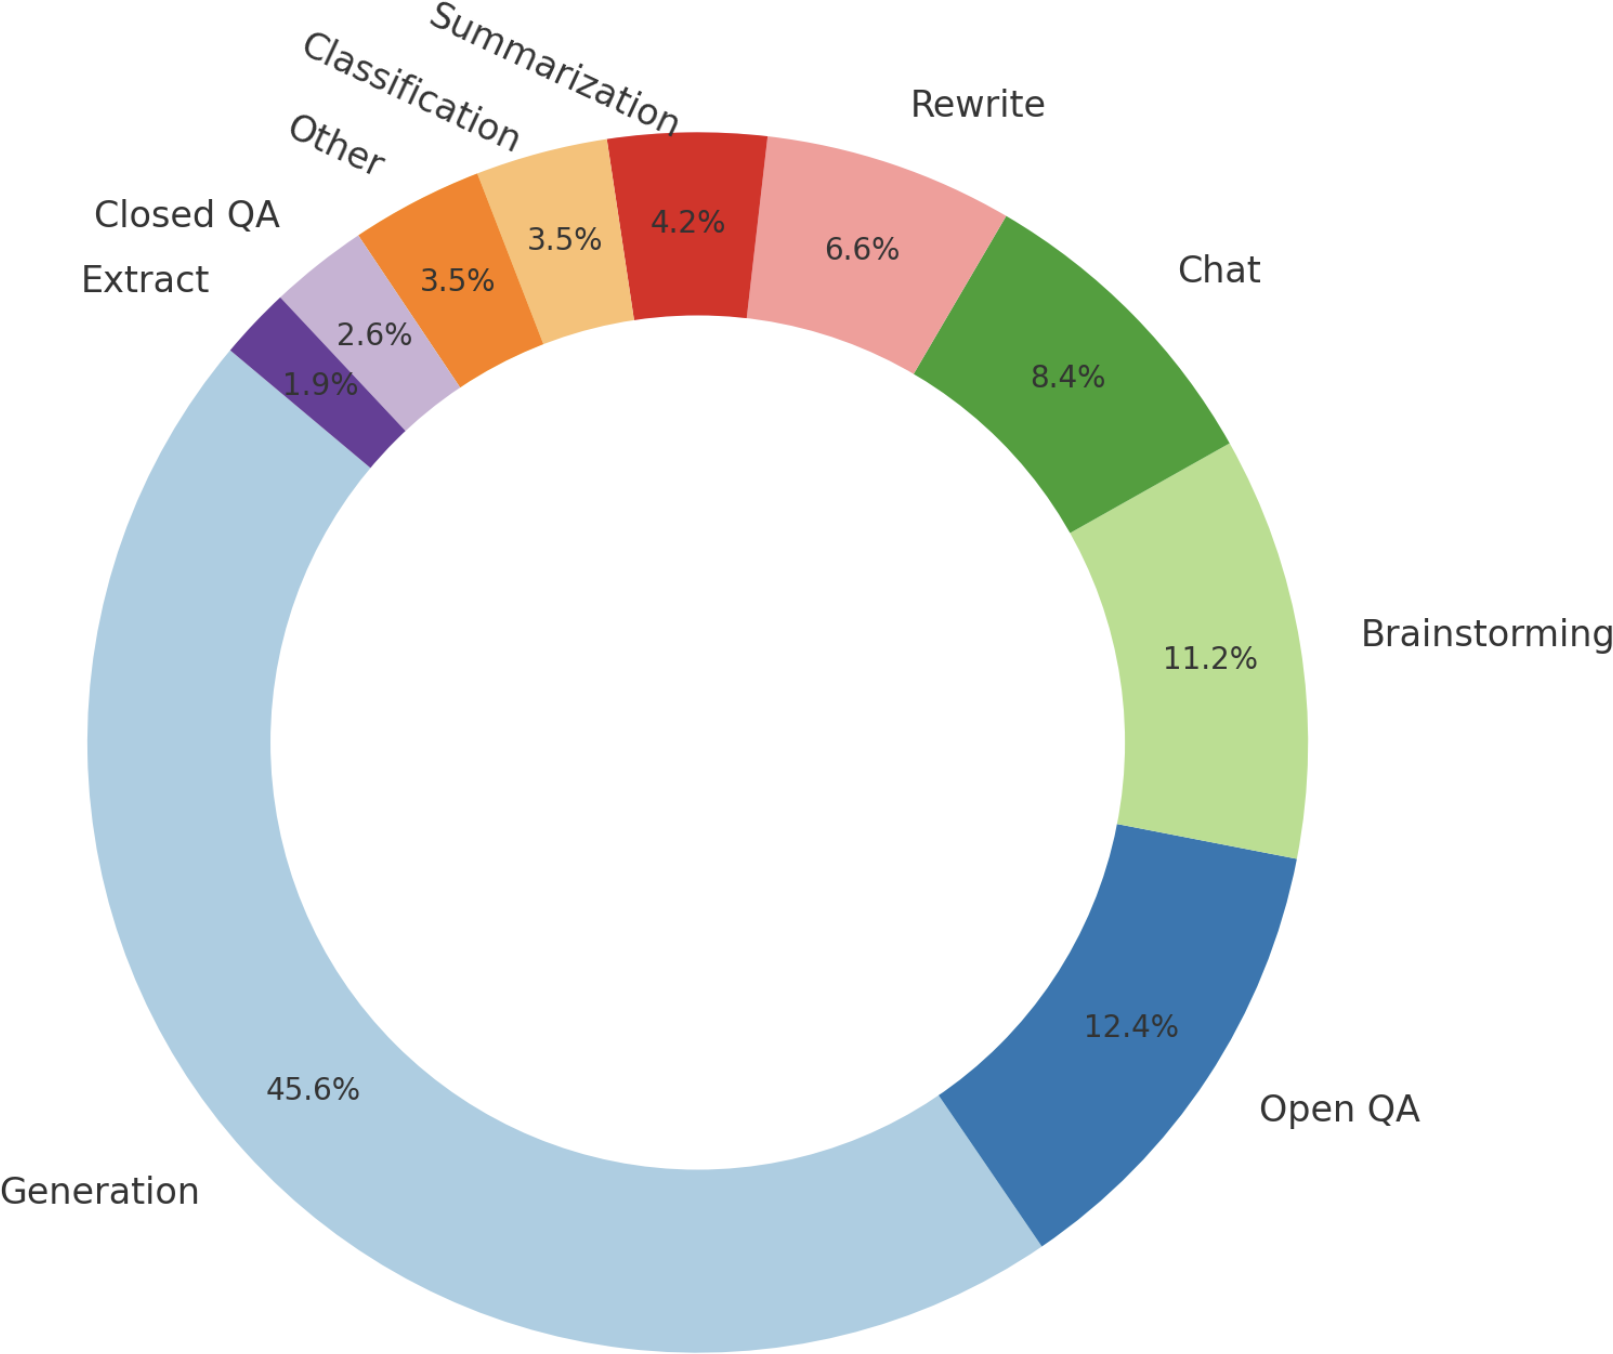
Repare que não tem tarefa multimodal ali, porque o InstructGPT trabalha só com texto.
A importância de bons rotuladores
Assim como uma pessoa aprende melhor com bons professores, a IA aprende melhor com bons rotuladores.
Na rotulagem tradicional, muita coisa pode ser feita com pouca experiência no assunto. Aqui é diferente. Os dados de demonstração podem ter prompts complexos, cujas respostas exigem pensamento crítico, pesquisa e bom senso para julgar se o pedido do usuário é adequado. Escrever esses exemplos dá trabalho e exige gente qualificada.
Amostragem
Um modelo monta a resposta por meio de um processo chamado amostragem. É ela que torna a saída da IA probabilística, e entender isso é a chave para lidar com inconsistência e alucinação.
Como o modelo escolhe uma resposta
Dada uma entrada, uma rede neural primeiro calcula a probabilidade de cada resultado possível.
Num modelo de classificação de spam, só existem dois resultados: spam e não spam. O modelo pode dizer que tem 90% de chance de ser spam e 10% de não ser. Aí você define uma regra, por exemplo "acima de 50% é spam", e o e-mail vai para a caixa de spam.
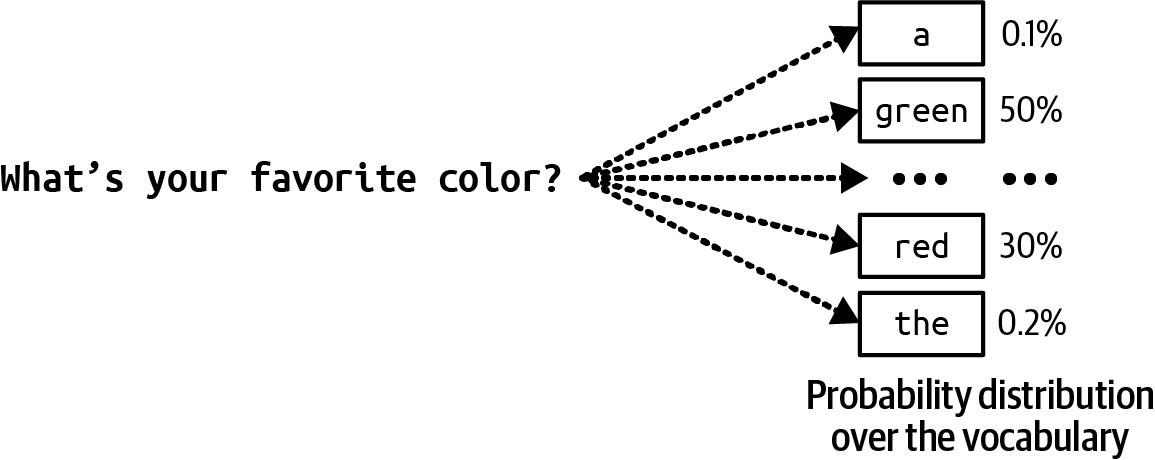
Num modelo de linguagem é a mesma ideia, só que em escala maior. Para gerar o próximo token, ele calcula a probabilidade de todos os tokens do vocabulário:
Amostragem gananciosa
A estratégia mais óbvia é sempre escolher o token mais provável. Isso se chama amostragem gananciosa (greedy sampling).
Em classificação funciona bem. Se o modelo acha que o e-mail é mais provável de ser spam, faz sentido marcar como spam.
Mas para gerar texto, o resultado fica chato. Imagine um modelo que, para qualquer pergunta, sempre responde com as palavras mais comuns.
Em vez disso, o modelo pode sortear o próximo token de acordo com a distribuição. Se "vermelho" tem 30% de chance e "verde" tem 50%, "vermelho" vai ser escolhido 30% das vezes e "verde" 50%.
Logits
E de onde vêm essas probabilidades? A rede neural gera um vetor de logits. Cada logit corresponde a um token do vocabulário, então o tamanho do vetor é o tamanho do vocabulário.
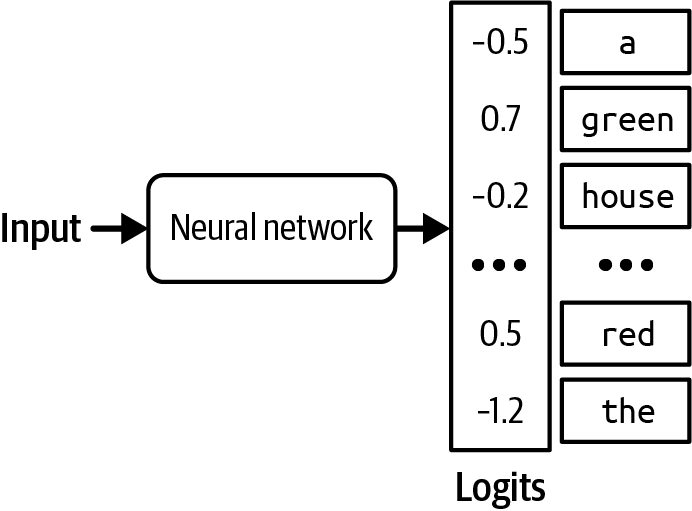
Logits não são probabilidades: podem ser negativos e não somam 1. Para virar probabilidade, eles passam por uma função chamada softmax. É em cima desses valores que as estratégias de amostragem trabalham.
Estratégias de amostragem
A estratégia certa faz o modelo gerar respostas mais adequadas para a sua aplicação. Uma pode deixar o modelo mais criativo, outra mais previsível. Dá até para criar a sua, mas isso normalmente exige acesso aos logits do modelo.
Temperatura
Sortear pela distribuição já ajuda, mas os tokens comuns continuam dominando. Para "Minha cor favorita é...", as cores mais comuns têm as maiores probabilidades e o modelo acaba respondendo como uma criança de cinco anos: "Minha cor favorita é verde".
Como "a" tem probabilidade baixa, quase nunca sai algo como "Minha cor favorita é a cor de um lago parado numa manhã de primavera".
A temperatura redistribui essas probabilidades:
- Temperatura alta: reduz a probabilidade dos tokens comuns e aumenta a dos raros. As respostas ficam mais criativas, mas podem perder coerência.
- Temperatura baixa: aumenta a chance de o modelo escolher o óbvio. As respostas ficam mais consistentes, mas mais sem graça.
É comum usar 0,7 para casos criativos, porque equilibra criatividade e previsibilidade. Mas vale testar e achar o valor que funciona melhor para o seu caso.
Top-k
O top-k reduz a carga de computação sem sacrificar muito a diversidade. Em vez de considerar o vocabulário inteiro, o modelo:
- Ordena os tokens por probabilidade.
- Mantém só os k mais prováveis.
- Normaliza as probabilidades só desse grupo.
- Sorteia entre esses k.
Ou seja, ele cria um pool pequeno de candidatos plausíveis para a próxima palavra.
A parte mais pesada do cálculo é o softmax aplicado sobre dezenas de milhares de tokens. Limitando a k valores, o modelo faz menos conta a cada token e gera mais rápido. Dependendo da diversidade que você quer, k costuma ficar entre 50 e 500, bem menos que o tamanho do vocabulário.
Se k for pequeno (1 a 20):
- Poucas opções no pool.
- Mais previsibilidade.
- Menos diversidade.
Se k for grande (100 a 500):
- Mais opções no pool.
- Texto mais criativo e variado.
- Pode ficar menos previsível ou até incoerente.
Top-p
No top-k, o número de candidatos é sempre o mesmo. Só que isso deveria mudar conforme a pergunta. Para "Você gosta de música? Responda só sim ou não", só faz sentido considerar dois tokens. Para "Qual o sentido da vida?", faz sentido considerar muitos.
O top-p, também chamado de amostragem de núcleo (nucleus sampling), resolve isso. O modelo soma as probabilidades dos tokens mais prováveis, em ordem decrescente, e para quando a soma chega em p. Só os tokens dentro dessa soma entram no sorteio.
Os valores comuns ficam entre 0,9 e 0,95. Com p = 0,9, o modelo considera o menor conjunto de tokens que soma mais de 90%.
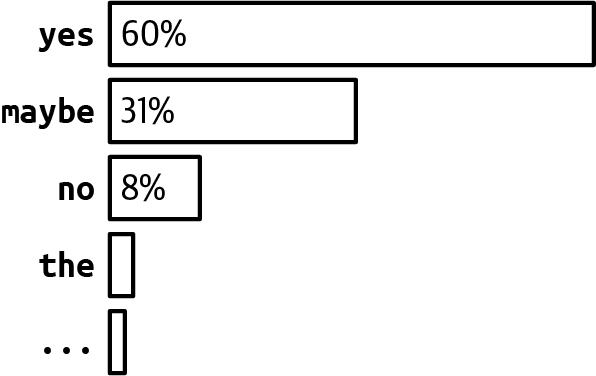
Uma analogia: você está num restaurante, em dúvida sobre o que pedir, e fala para o garçom:
"Me traz as opções que, juntas, somam 90% das chances de eu escolher."
O garçom começa pelos pratos mais pedidos e vai juntando até passar desses 90%. Esse conjunto é o núcleo. Então o modelo:
- Ordena as palavras pela chance de acontecer.
- Soma as probabilidades até passar de p.
- Sorteia a próxima palavra só dentro desse conjunto.
Diferente do top-k, o top-p não reduz necessariamente o custo do softmax. A vantagem dele é focar só nos valores mais relevantes para cada contexto. Na teoria não parece grande coisa, mas na prática funciona bem, e por isso ficou tão popular.
Condição de parada
Um modelo autorregressivo gera um token depois do outro. Uma resposta longa demora mais, custa mais e às vezes irrita o usuário. Por isso vale definir quando o modelo deve parar.
- Número máximo de tokens: é simples, mas a resposta pode ser cortada no meio da frase.
- Tokens ou palavras de parada: o modelo para quando gera um token específico, como o de fim de sequência.
As condições de parada ajudam a manter a latência e o custo baixos.
A natureza probabilística da IA
Pense que você pergunta para um amigo qual é a melhor culinária do mundo. Se perguntar de novo um minuto depois, ele vai dar a mesma resposta.
Com um modelo de IA não é assim. Se ele acha que a culinária vietnamita tem 70% de chance de ser a melhor e a italiana 30%, ele vai responder "vietnamita" 70% das vezes e "italiana" 30% das vezes.
Isso causa dois problemas:
- Inconsistência: o modelo gera respostas muito diferentes para o mesmo prompt, ou para prompts quase iguais.
- Alucinação: o modelo dá uma resposta que não tem base em fatos.
Os modelos base são treinados com uma quantidade enorme de dados. Eles são uma agregação da opinião de muita gente e carregam, literalmente, um mundo de possibilidades. Qualquer coisa com probabilidade diferente de zero, por mais absurda ou errada que seja, pode ser gerada.
Isso é ótimo para tarefas criativas. Criatividade é justamente explorar além do caminho óbvio, e a IA pode gerar ideias sem fim. Mas essa mesma característica vira problema em quase todo o resto.
Inconsistência
Ela aparece de dois jeitos:
- Mesma entrada, saídas diferentes: você manda o mesmo prompt duas vezes e recebe duas respostas bem diferentes.
- Entrada levemente diferente, saídas muito diferentes: você muda uma letra para maiúscula sem querer e o resultado muda completamente.
Isso quebra a experiência do usuário. Numa conversa entre pessoas, a gente espera consistência. Imagine alguém que te diz um nome diferente cada vez que te encontra. Com a IA, as pessoas esperam o mesmo.
Como reduzir a inconsistência
Para o caso de mesma entrada com saídas diferentes, dá para:
- Fazer cache da resposta, para que a mesma pergunta receba sempre a mesma resposta.
- Fixar as variáveis de amostragem: temperatura, top-p e top-k.
Mesmo assim, não existe garantia de 100% de consistência. O hardware onde o modelo roda também influencia a saída, porque máquinas diferentes executam as mesmas instruções de jeitos diferentes e lidam com faixas numéricas diferentes. Se você hospeda o modelo, tem algum controle sobre isso. Se usa uma API como a da OpenAI ou do Google, depende do que o provedor oferece.
No fim, trabalhar com IA é aceitar que ela é probabilística e construir o fluxo da aplicação em volta disso. E se a saída varia, você precisa de uma forma de medir se ela está boa, que é o assunto do próximo artigo: como avaliar um modelo.
Referência
Este artigo faz parte dos meus estudos sobre engenharia de IA, baseados no livro AI Engineering: Building Applications with Foundation Models, de Chip Huyen (O'Reilly, 2025). As imagens usadas aqui também vêm do livro.