Como medir um modelo: entropia, perplexidade e IA como juiz
Entropia, entropia cruzada, perplexidade e correção funcional, e como usar uma IA como juiz sabendo dos limites e vieses dela.
Série · Parte 5 de 14 Engenharia de IA
- 01 De Sherlock ao GPT: a estatística por trás da linguagem 7 min
- 02 O que existe dentro de um modelo base 9 min
- 03 Parâmetros, computação e os limites da escala 8 min
- 04 Pós-treinamento e amostragem: por que a IA responde diferente a cada vez 9 min
- 05 Como medir um modelo: entropia, perplexidade e IA como juiz 10 min
- 06 Critérios de avaliação: sua IA realmente ajuda o negócio? 6 min
- 07 Escolhendo um modelo: API, código aberto e benchmarks 10 min
- 08 Do pipeline de avaliação ao primeiro prompt 11 min
- 09 Boas práticas de engenharia de prompt 9 min
- 10 RAG: dando contexto ao modelo 13 min
- 11 RAG na prática: otimizando a recuperação 9 min
- 12 Agentes: ferramentas e planejamento 13 min
- 13 Agentes: execução, falhas e memória 12 min
- 14 Arquitetura de uma aplicação de IA 11 min
Neste artigo13 seções
Quanto mais a IA entra no dia a dia, maior a chance de alguma coisa dar muito errado. E já deu: um homem tirou a própria vida depois de ser incentivado por um chatbot, advogados apresentaram em tribunal jurisprudências que a IA simplesmente inventou e a Air Canada foi condenada a indenizar um passageiro porque o chatbot dela passou uma informação falsa sobre reembolso.
Sem uma forma de controlar a qualidade do que a IA entrega, o risco pode ser maior do que o benefício. É aqui que entra a avaliação.
Por que avaliar é tão difícil
Avaliar um modelo tradicional é medir o quanto ele acerta na tarefa para a qual foi treinado. Com modelos de uso geral isso muda, porque além de medir o que já sabemos que ele faz, a avaliação também precisa descobrir o que mais ele consegue fazer e onde estão os limites.
À medida que a IA é adotada, aparece um obstáculo grande: saber se o resultado gerado é realmente aceitável dentro das políticas e do objetivo do produto.
O objetivo da avaliação é reduzir riscos e descobrir oportunidades. Para reduzir riscos, primeiro você precisa saber onde o seu sistema provavelmente vai falhar e montar a avaliação em volta desses pontos. Às vezes isso exige até mudar o sistema para que as falhas fiquem mais visíveis. Sem saber onde ele falha, nenhuma métrica ou ferramenta vai deixar o sistema robusto.
Você não pode mais avaliar uma resposta pela aparência dela. É preciso checar os fatos, o raciocínio e, muitas vezes, trazer conhecimento do domínio.
Na prática, muita gente avalia a própria aplicação de IA só olhando os resultados, com um punhado de prompts escolhidos de cabeça. Isso até funciona no começo de um projeto, mas não aguenta a evolução da aplicação. Os prompts de teste precisam nascer das necessidades da aplicação, não da experiência pessoal de quem está testando.
Antes de falar de critérios e ferramentas, vale entender as métricas que vêm da própria forma como os modelos de linguagem são treinados.
Entropia
A entropia é uma medida de incerteza ou surpresa em um conjunto de eventos. Quanto mais difícil prever o próximo evento, maior a entropia.
Imagine que você quer criar uma linguagem para descrever posições dentro de um quadrado.
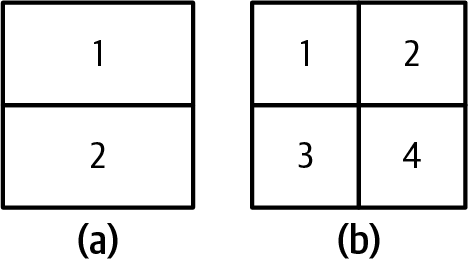
- Com dois tokens, cada um só diz se a posição é em cima ou embaixo. Um bit basta para representar isso, então a entropia dessa linguagem é 1.
- Com quatro tokens, cada um diz uma posição mais específica: superior esquerdo, superior direito, inferior esquerdo ou inferior direito. Agora são necessários dois bits, e a entropia é 2.
A segunda linguagem carrega mais informação por token, mas cada token custa mais bits para ser representado.
Resumindo: a entropia mede a dificuldade de prever o que vem a seguir. Quanto menor a entropia, ou seja, quanto menos informação cada token carrega, mais previsível é a linguagem.
Entropia cruzada
A entropia cruzada mede o quão difícil é para o modelo fazer boas previsões sobre um conjunto de dados.
- Se o modelo fosse perfeito, ele sempre acertaria a próxima palavra e a entropia cruzada seria baixa.
- Se ele se perde nas previsões, ela sobe.
Tecnicamente, ela diz quantos bits, em média, são necessários para representar eventos de uma distribuição verdadeira quando você usa uma distribuição estimada no lugar dela. O modelo é a distribuição estimada, e os dados de treinamento são a verdadeira.
Um modelo de linguagem é treinado justamente para minimizar a entropia cruzada em relação aos dados de treinamento. Se ele aprendesse os dados perfeitamente, a entropia cruzada dele seria igual à entropia dos próprios dados.
Bits por caractere e bits por byte
A unidade da entropia e da entropia cruzada é o bit. Se a entropia cruzada de um modelo é de 6 bits, ele precisa de 6 bits para representar cada token.
O problema é que cada modelo tokeniza o texto de um jeito (um usa palavras, outro usa pedaços de palavras, outro usa caracteres), então bits por token não servem para comparar modelos diferentes. Por isso existem outras medidas:
- Bits por caractere (BPC): se o modelo usa 6 bits por token e cada token tem, em média, 2 caracteres, o BPC é 6 / 2 = 3.
- Bits por byte (BPB): resolve um problema do BPC, que depende da codificação. No ASCII cada caractere usa 7 bits, no UTF-8 pode usar de 8 a 32. O BPB mede quantos bits o modelo precisa para representar um byte do texto original. Com BPC 3 e caracteres de 7 bits (⅞ de byte), o BPB é 3 / (⅞) = 3,43.
Isso tem uma consequência curiosa: a entropia cruzada diz o quanto o modelo é bom em comprimir texto. Um BPB de 3,43 significa que cada byte original (8 bits) pode ser representado com 3,43 bits, ou seja, o modelo consegue compactar o texto para menos da metade do tamanho.
Perplexidade
A perplexidade (PPL) é a exponencial da entropia e da entropia cruzada.
Se a entropia cruzada mede a dificuldade de prever o próximo token, a perplexidade mede quantas opções o modelo considera possíveis na hora de prever. Mais incerteza significa mais candidatos para o próximo token.
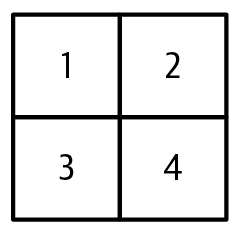
Voltando ao quadrado com quatro posições: um modelo que aprendeu perfeitamente essa linguagem tem entropia cruzada de 2 bits. Na hora de prever uma posição, ele precisa escolher entre 2² = 4 opções. A perplexidade dele é 4.
Aqui usei o bit como unidade, por isso a base 2. Frameworks como TensorFlow e PyTorch usam o nat, que é baseado no logaritmo natural (base e).
Como interpretar
Entropia cruzada, perplexidade, BPC e BPB são variações da mesma ideia: medir o quanto o modelo prevê bem um texto. Quanto melhor a previsão, menores esses números.
Uma perplexidade alta em um conjunto de dados quer dizer que o modelo está mais incerto sobre o que vem a seguir naquele tipo de texto.
Correção funcional
As métricas acima falam sobre o modelo. Mas o que importa para quem usa é outra pergunta: o sistema faz o que deveria fazer?
Isso é a correção funcional. Se você pede para um modelo criar um site, o site atende aos requisitos? Se pede para reservar uma mesa em um restaurante, a reserva foi feita?
É a métrica definitiva para qualquer aplicação, porque mede o resultado que importa. O problema é que nem sempre é fácil medir, e muito menos automatizar essa medição. Código é uma exceção: dá para rodar testes e ver se passa.
IA como juiz
Se a IA já automatiza tantas tarefas difíceis, por que não usar a própria IA para avaliar? Essa abordagem é chamada de IA como juiz ou LLM como juiz.
Os juízes de IA são rápidos, fáceis de usar e baratos se comparados com avaliadores humanos. E funcionam sem dados de referência, o que permite usá-los direto em produção.
Você pode pedir para o juiz avaliar praticamente qualquer critério: correção, repetição, toxicidade, completude, alucinação. Além de dar a nota, ele pode explicar a decisão, o que ajuda muito na hora de auditar.
Ao usar um juiz, é preciso dar a ele contexto e insumos para decidir se a entrada bate com o que é aceitável no sistema. E é muito importante armazenar a justificativa do juiz, o porquê de ele ter chegado naquela conclusão.
O que um juiz precisa
Para montar uma IA como juiz, você precisa definir:
- A tarefa: o que o juiz vai avaliar, por exemplo, a relevância da resposta.
- Os critérios: algo como "verifique se a resposta gerada tem informação suficiente para responder à pergunta, de acordo com a resposta de referência". Critérios comuns são fundamentação, relevância e coerência.
- O sistema de pontuação: valores discretos, como de 1 a 5, funcionam como uma classificação em que cada classe tem um significado numérico.
- O método de comparação, que pode ser um destes três:
- avaliar a resposta sozinha, considerando a pergunta original;
- comparar a resposta gerada com uma resposta de referência;
- comparar duas respostas geradas e dizer qual é melhor, ou qual o usuário provavelmente vai preferir.
- Um log da justificativa, para saber por que o juiz escolheu B e não A.
- Os vieses que esse juiz tem (falo deles mais abaixo).
Prompts com exemplos funcionam melhor. Se a escala é de 1 a 5, mostre como é uma resposta nota 1, 2, 3, 4 e 5 e, se possível, explique o motivo de cada nota.
Cada função de avaliação vai precisar do seu próprio prompt de juiz.
Limitações
O juiz também é uma IA, então também é probabilístico. O mesmo juiz, com a mesma entrada, pode dar notas diferentes se o prompt mudar um pouco.
Dá para deixar o juiz mais consistente fixando as variáveis de amostragem e colocando exemplos de avaliação no prompt. Em um experimento, isso levou a consistência do GPT-4 de 65% para 77,5%. Mas consistência não é precisão: o juiz pode errar sempre do mesmo jeito. E mais exemplos deixam o prompt maior, o que aumenta o custo de inferência.
E tem uma pergunta que fica: quem mede o juiz? Ele está ali para dizer se algo é bom ou ruim, mas e se ele mesmo errar muito?
Outro ponto é custo. Colocar um juiz pode dobrar o número de chamadas na API, o que aumenta latência e custo. Uma saída é usar modelos menores como juízes.
Quais modelos podem ser juízes
A intuição diz que o juiz deve ser mais forte que o modelo avaliado, como o professor que sabe mais que o aluno. Um modelo forte, além de julgar melhor, pode ajudar a melhorar o mais fraco.
Uma estratégia comum quando não há orçamento para usar o modelo mais forte em tudo: gerar as respostas com um modelo barato e usar o modelo forte para avaliar só uma amostra, por exemplo 1% das respostas. Se o modelo forte achar que a resposta ficou ruim, dá para corrigir, inclusive trocando pela resposta dele.
Usar o modelo para julgar a si mesmo (autoavaliação) parece trapaça por causa do viés, mas funciona bem como checagem de sanidade. Se o próprio modelo acha que a resposta dele está errada, ela provavelmente não é confiável.
Ainda está em aberto se o juiz pode ser mais fraco que o modelo avaliado. Tem quem defenda que julgar é mais fácil que gerar: qualquer pessoa consegue dizer se uma música é boa, mas pouca gente consegue compor uma.
Vieses do juiz
Assim como avaliadores humanos, juízes de IA têm vieses. Conhecer esses vieses ajuda a interpretar as notas e a reduzir o efeito deles.
- Autopreferência: o modelo tende a favorecer as próprias respostas. O mesmo mecanismo que faz ele gerar a resposta mais provável faz ele dar nota alta para ela. Em um experimento de 2023, o GPT-4 favoreceu a si mesmo com uma taxa de vitória 10% maior, e o Claude-v1, 25% maior.
- Primeira posição: muitos juízes preferem a primeira resposta de uma comparação ou a primeira de uma lista. Dá para reduzir isso repetindo o teste com a ordem trocada. Curiosamente, humanos fazem o contrário e tendem a preferir a última que viram, o chamado viés de recência.
- Verbosidade: alguns juízes preferem respostas mais longas, independente da qualidade. Um estudo de 2023 mostrou que GPT-4 e Claude-1 preferiam respostas de cerca de 100 palavras com erros factuais a respostas corretas de cerca de 50 palavras. Em tarefas criativas, quando uma resposta tem o dobro do tamanho da outra, o juiz quase sempre escolhe a mais longa.
Com as métricas e o juiz em mãos, o próximo passo é decidir o que avaliar, ou seja, quais critérios mostram se a aplicação realmente entrega valor.
Referência
Este artigo faz parte dos meus estudos sobre engenharia de IA, baseados no livro AI Engineering: Building Applications with Foundation Models, de Chip Huyen (O'Reilly, 2025). As imagens usadas aqui também vêm do livro.