Parâmetros, computação e os limites da escala
O que são parâmetros, quanto custa treinar um modelo, a lei de Chinchilla e os gargalos de dados e energia.
Série · Parte 3 de 14 Engenharia de IA
- 01 De Sherlock ao GPT: a estatística por trás da linguagem 7 min
- 02 O que existe dentro de um modelo base 9 min
- 03 Parâmetros, computação e os limites da escala 8 min
- 04 Pós-treinamento e amostragem: por que a IA responde diferente a cada vez 9 min
- 05 Como medir um modelo: entropia, perplexidade e IA como juiz 10 min
- 06 Critérios de avaliação: sua IA realmente ajuda o negócio? 6 min
- 07 Escolhendo um modelo: API, código aberto e benchmarks 10 min
- 08 Do pipeline de avaliação ao primeiro prompt 11 min
- 09 Boas práticas de engenharia de prompt 9 min
- 10 RAG: dando contexto ao modelo 13 min
- 11 RAG na prática: otimizando a recuperação 9 min
- 12 Agentes: ferramentas e planejamento 13 min
- 13 Agentes: execução, falhas e memória 12 min
- 14 Arquitetura de uma aplicação de IA 11 min
Neste artigo17 seções
- O que são parâmetros
- Pesos (weights)
- Vieses (biases)
- Por que o número de parâmetros importa
- Modelos esparsos
- Tamanho do modelo não é tudo
- Como medir o tamanho dos dados
- Computação no pré-treinamento
- FLOP e FLOP/s
- Quanto custa treinar o GPT-3
- Os três números que indicam a escala
- A lei de Chinchilla
- Os limites da escala
- Gargalo de dados
- Uma internet artificial
- Gargalo de energia
- Referência
É difícil falar de modelos de fundação sem falar do número de parâmetros. Quando você vê um nome como Llama-13B, ele está dizendo que é um modelo da família Llama, da Meta, com 13 bilhões de parâmetros.
Mas o que exatamente é um parâmetro, e por que esse número importa tanto?
O que são parâmetros
Imagine que um modelo de IA é uma receita de bolo.
- Os ingredientes brutos (farinha, açúcar, ovos) são os dados que você coloca no modelo.
- Os parâmetros são as quantidades de cada ingrediente: quanta farinha, quanto açúcar. Mudar essas quantidades muda o sabor e a textura do bolo.
Em termos técnicos, parâmetros são números que o modelo aprende e que determinam como ele transforma uma entrada em uma saída (texto em texto, uma classificação, uma resposta). Durante o treinamento esses números vão sendo ajustados para o modelo errar cada vez menos, até chegar na receita de bolo perfeita.
No treinamento, o modelo aprende o formato e o padrão de uma boa receita. Na inferência, que é quando você usa o modelo, ele aplica essa receita para produzir uma resposta nova.
Em modelos como o GPT-5, os parâmetros são principalmente de dois tipos.
Pesos (weights)
Os pesos definem o quanto cada informação importa. Numa rede neural, cada conexão entre neurônios tem um peso que diz o quanto a saída de um neurônio influencia o próximo.
Pense que você está decidindo onde jantar com os amigos. As opções são comida japonesa, pizza ou hamburgueria.
- Todo mundo ama pizza.
- O Bob é alérgico a frutos do mar.
A opinião do grupo sobre pizza tem um peso alto e positivo. A alergia do Bob tem um peso forte e negativo para o japonês. Cada informação entra na decisão com uma importância diferente, e é isso que os pesos fazem.
Vieses (biases)
Os vieses dão ao modelo um ponto de partida, um ajuste base. Eles empurram o resultado para cima ou para baixo, independente dos pesos.
Antes mesmo de ouvir a opinião de alguém sobre o jantar, você já pensa: "é sexta, quero algo gostoso". Esse instinto inicial é o viés. Ele ajusta a decisão antes de qualquer entrada chegar.
Por que o número de parâmetros importa
O número de parâmetros ajuda a estimar quanto de computação é preciso para treinar e rodar o modelo.
Se um modelo tem 7 bilhões de parâmetros e cada um é armazenado em 2 bytes (16 bits), dá para calcular que a GPU vai precisar de pelo menos 14 GB de memória só para fazer inferência com ele.
Modelos esparsos
O número de parâmetros pode enganar se o modelo for esparso, ou seja, se boa parte dos parâmetros for zero. Um modelo de 7B que é 90% esparso tem só 700 milhões de parâmetros diferentes de zero.
A esparsidade deixa o armazenamento e a computação mais eficientes. Um modelo esparso grande pode precisar de menos computação do que um modelo denso pequeno.
Tamanho do modelo não é tudo
Um modelo maior pode ser pior do que um menor se não tiver dados suficientes. Imagine um modelo de 13 bilhões de parâmetros treinado com uma única frase: "Eu gosto de abacaxis". Ele vai ser muito pior do que um modelo pequeno treinado com bastante dado.
Por isso, ao falar de tamanho de modelo, sempre olhe também o tamanho dos dados.
Como medir o tamanho dos dados
Contar amostras de treinamento não funciona bem para modelos de linguagem. Uma amostra pode ser uma frase, uma página da Wikipédia, uma conversa ou um livro inteiro, e um livro vale muito mais que uma frase.
A medida mais usada é o número de tokens do dataset. Também não é perfeita, porque cada modelo tokeniza de um jeito e o mesmo dataset pode ter quantidades diferentes de tokens dependendo do modelo. Mas como o token é a unidade com que o modelo trabalha, essa contagem diz bem quanto ele pode aprender daqueles dados.
Computação no pré-treinamento
Treinar um modelo grande exige muita computação. Uma forma de medir seria contar máquinas (GPUs, CPUs, TPUs), mas máquinas diferentes têm capacidades e custos bem diferentes. Uma NVIDIA A10 não se compara a uma H100.
FLOP e FLOP/s
A unidade mais usada é o FLOP (floating point operation, operação de ponto flutuante), que conta quantas operações uma tarefa precisa.
- O maior PaLM-2, do Google, foi treinado com cerca de
10^22FLOPs (Chowdhery et al., 2022). - O GPT-3-175B usou
3,14 × 10^23FLOPs (Brown et al., 2020).
Cuidado com a diferença: FLOPs é quanto uma tarefa exige, FLOP/s é quanto uma máquina entrega por segundo. Uma NVIDIA H100 NVL entrega no máximo 60 TeraFLOP/s, ou 6 × 10^13 FLOPs por segundo, o que dá 5,2 × 10^18 FLOPs por dia.
Quanto custa treinar o GPT-3
Suponha que você tenha 256 H100 rodando na capacidade máxima, sem nenhum erro de treinamento:
(3,14 × 10^23) / (256 × 5,2 × 10^18) ≈ 236 diasQuase 8 meses. Na prática ninguém usa 100% da GPU. Com 70% de utilização e US$ 2 por hora de H100, o treinamento do GPT-3-175B passaria de US$ 4 milhões.
Os três números que indicam a escala
- Número de parâmetros: a capacidade de aprendizado do modelo.
- Número de tokens de treinamento: o quanto ele aprendeu.
- Número de FLOPs: o custo do treinamento.
E disso saem três conclusões:
- O desempenho depende do tamanho do modelo e do tamanho dos dados.
- Modelos e datasets maiores exigem mais computação.
- Computação custa dinheiro.
A lei de Chinchilla
A menos que você tenha dinheiro infinito, o orçamento manda. Ninguém começa escolhendo um modelo gigante para depois ver quanto custa. O caminho é o contrário: você define quanto pode gastar e descobre qual o melhor modelo que cabe nesse valor.
Como computação costuma ser o fator que limita (é cara e difícil de montar), os times geralmente começam por um orçamento de computação. A pergunta vira: com uma quantidade fixa de FLOPs, qual combinação de tamanho de modelo e tamanho de dataset dá o melhor resultado? O modelo que atinge isso é chamado de compute-optimal, ou ótimo em computação.
A regra para responder isso é a lei de escalonamento de Chinchilla, do artigo "Training Compute-Optimal Large Language Models" (DeepMind, 2022). Os autores treinaram 400 modelos, de 70 milhões a mais de 16 bilhões de parâmetros, com 5 a 500 bilhões de tokens. A conclusão:
- O número de tokens de treinamento deve ser cerca de 20 vezes o número de parâmetros. Um modelo de 3B precisa de uns 60B tokens.
- Modelo e dados devem crescer juntos: se dobrar o tamanho do modelo, dobre também os tokens de treinamento.
Os limites da escala
Até agora, cada aumento de ordem de grandeza no tamanho dos modelos trouxe ganho de desempenho:
- GPT-2 tem uma ordem de grandeza a mais que o GPT-1 (1,5 bilhão contra 117 milhões).
- GPT-3 tem duas ordens a mais que o GPT-2 (175 bilhões contra 1,5 bilhão).
São três ordens de grandeza entre 2018 e 2021. Mais três dariam modelos de 100 trilhões de parâmetros.
Até onde isso vai? Existe um ponto em que o modelo para de melhorar, não importa o tamanho? Difícil responder, mas já dá para ver dois gargalos claros: dados e eletricidade.
Gargalo de dados
Os modelos consomem tantos dados que existe uma preocupação real de que a internet acabe nos próximos anos. O tamanho dos datasets de treinamento cresce muito mais rápido do que a geração de dados novos (Villalobos et al., 2022).
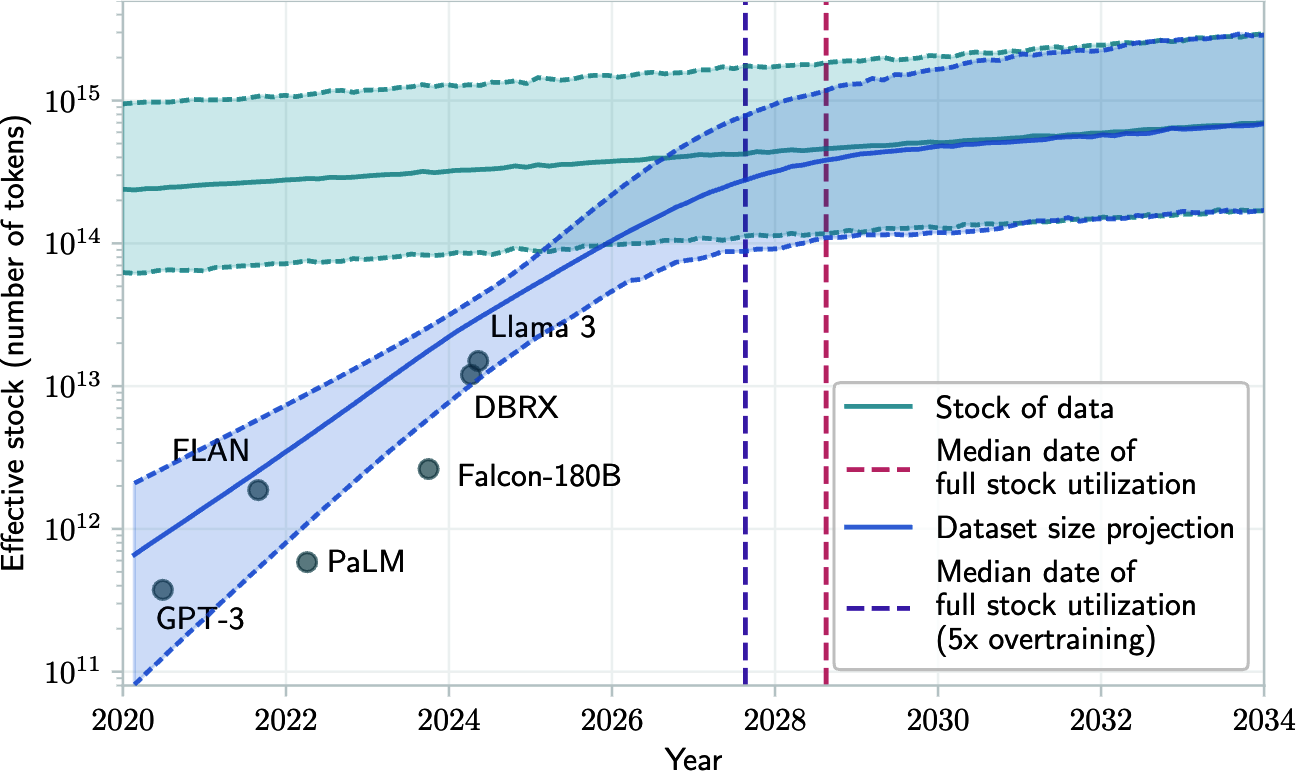
Se você já publicou alguma coisa na internet, pode assumir que ela já está, ou vai estar, nos dados de treinamento de algum modelo, tendo você consentido ou não. É parecido com publicar algo e esperar que o Google indexe.
Tem quem use isso a seu favor: publica textos na internet esperando que eles entrem no treinamento de modelos futuros e influenciem as respostas que eles vão dar.
Uma internet artificial
Outro ponto: a internet está ficando cheia de conteúdo gerado por IA. Se as empresas continuarem treinando com dados da internet, os próximos modelos vão aprender, em parte, com texto que outra IA escreveu.
Algumas pesquisas temem que treinar modelos de forma recursiva com dados gerados por IA faça eles esquecerem aos poucos os padrões originais, piorando o desempenho com o tempo (Shumailov et al., 2023).
Quando os dados públicos acabarem, o caminho mais viável para conseguir mais dados humanos são os dados proprietários: livros com direitos autorais, traduções, contratos, prontuários médicos, sequências de genoma. Quem tiver esses dados vai ter vantagem na corrida da IA. É por isso que a OpenAI fechou acordos com editoras e veículos de mídia como a Axel Springer e a Associated Press.
Gargalo de energia
O outro gargalo é menos óbvio, mas mais urgente: eletricidade. Máquina precisa de energia para funcionar.
Hoje estima-se que os data centers consomem de 1% a 2% da eletricidade do mundo, e a projeção é chegar entre 4% e 20% até 2030. Sem uma forma de produzir mais energia, os data centers conseguem crescer no máximo umas 50 vezes, menos de duas ordens de grandeza. Isso gera um risco real de falta de energia e de aumento no custo da eletricidade.
No próximo artigo eu falo do que acontece depois do pré-treinamento: como o modelo é ajustado para conversar com pessoas e por que ele pode responder diferente cada vez que você pergunta a mesma coisa.
Referência
Este artigo faz parte dos meus estudos sobre engenharia de IA, baseados no livro AI Engineering: Building Applications with Foundation Models, de Chip Huyen (O'Reilly, 2025). As imagens usadas aqui também vêm do livro.