O que existe dentro de um modelo base
Dados de treinamento, o peso do inglês, a arquitetura transformer, o mecanismo de atenção e o que é a janela de contexto.
Série · Parte 2 de 14 Engenharia de IA
- 01 De Sherlock ao GPT: a estatística por trás da linguagem 7 min
- 02 O que existe dentro de um modelo base 9 min
- 03 Parâmetros, computação e os limites da escala 8 min
- 04 Pós-treinamento e amostragem: por que a IA responde diferente a cada vez 9 min
- 05 Como medir um modelo: entropia, perplexidade e IA como juiz 10 min
- 06 Critérios de avaliação: sua IA realmente ajuda o negócio? 6 min
- 07 Escolhendo um modelo: API, código aberto e benchmarks 10 min
- 08 Do pipeline de avaliação ao primeiro prompt 11 min
- 09 Boas práticas de engenharia de prompt 9 min
- 10 RAG: dando contexto ao modelo 13 min
- 11 RAG na prática: otimizando a recuperação 9 min
- 12 Agentes: ferramentas e planejamento 13 min
- 13 Agentes: execução, falhas e memória 12 min
- 14 Arquitetura de uma aplicação de IA 11 min
Neste artigo12 seções
Quando falamos de ChatGPT, Gemini ou Claude, estamos falando de modelos base (também chamados de modelos de fundação). Como eles são treinados, qual arquitetura usam e quais dados entraram no treinamento quase nunca é público, pela complexidade e pelo valor que isso tem para as empresas.
Mas dá para entender bem as peças principais.
O treinamento de um modelo costuma ser dividido em duas fases:
- Pré-treinamento: deixa o modelo capaz, mas não necessariamente seguro ou fácil de usar.
- Pós-treinamento: alinha o modelo às preferências humanas.
E tem uma terceira peça que quase todo mundo ignora: a amostragem, que é a forma como o modelo escolhe uma resposta entre todas as opções possíveis. Ela explica muita coisa estranha que a IA faz, como alucinações e respostas inconsistentes, e escolher bem a estratégia de amostragem pode melhorar bastante o resultado com pouco esforço. Pós-treinamento e amostragem ficam para os próximos artigos. Aqui o foco é no que vem antes.
Dados de treinamento
Um modelo de IA é tão bom quanto os dados em que foi treinado. Se você quer que ele seja bom em uma tarefa, precisa colocar dados dessa tarefa no treinamento.
O problema é que juntar dados suficientes para treinar um modelo grande é difícil e caro. Então quem desenvolve modelos acaba usando o que está disponível, mesmo que não seja exatamente o ideal.
Common Crawl
Uma das fontes mais usadas é o Common Crawl, mantido por uma organização sem fins lucrativos que rastreia sites da internet de tempos em tempos e registra tudo o que encontra.
A qualidade desses dados é questionável. Pense em clickbait, desinformação, propaganda, teoria da conspiração, racismo, misoginia e todo site suspeito que você já viu por aí. Tudo isso pode estar lá.
Você pode pensar: por que não treinar com tudo, dados gerais e especializados, para o modelo saber fazer tudo? Muita gente faz isso. Mas mais dados exigem mais computação e nem sempre dão um resultado melhor. Um modelo treinado com menos dados de alta qualidade pode superar um modelo treinado com muitos dados ruins.
O peso do inglês
Boa parte do material de treinamento é em inglês. Cerca de 45% do conteúdo armazenado pelo Common Crawl está nesse idioma.
Não é surpresa que os modelos de uso geral funcionem bem melhor em inglês do que em outros idiomas. O relatório do GPT-4 mostra isso no benchmark MMLU:
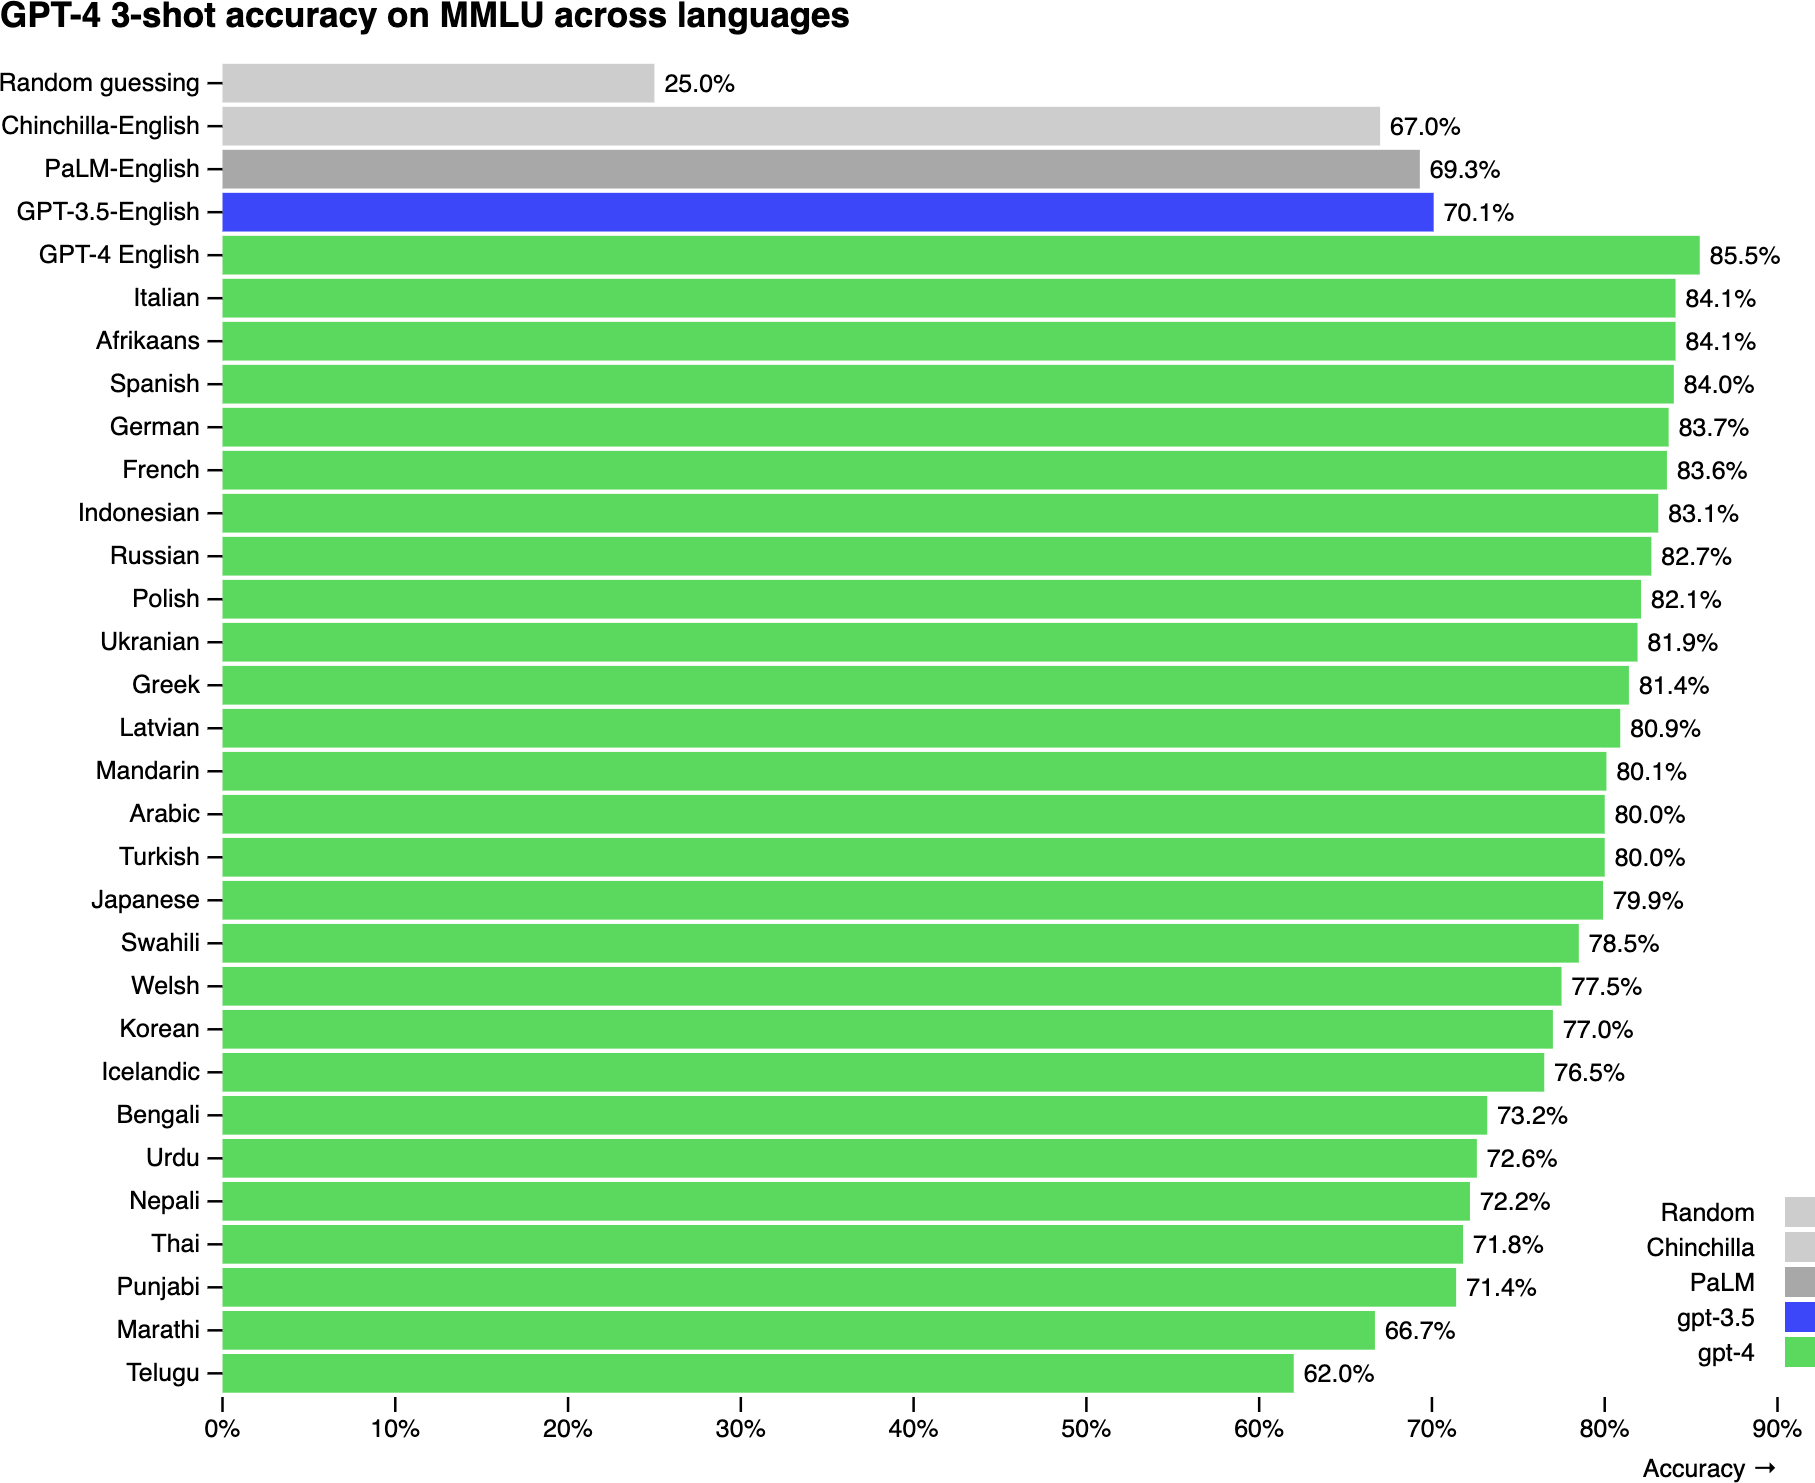
Além da quantidade de dados, a estrutura do idioma e a cultura que ele carrega também dificultam o aprendizado.
E se a gente traduzir tudo para o inglês?
Como os LLMs costumam ser bons em tradução, uma ideia é traduzir a pergunta para o inglês, obter a resposta e traduzir de volta. Muita gente faz isso, mas tem dois problemas:
- Você precisa de um modelo que entenda bem o idioma original para traduzir, e é justamente isso que falta nos idiomas com poucos dados.
- A tradução perde informação. No vietnamita, por exemplo, existem pronomes que indicam a relação entre as duas pessoas que estão conversando. Em inglês tudo vira "I" e "you", e essa relação some.
Custo e latência por idioma
Tem também a questão do custo. A latência e o preço de uma chamada são proporcionais ao número de tokens, e alguns idiomas precisam de muito mais tokens para dizer a mesma coisa.
Yennie Jun analisou isso com o GPT-4 no dataset MASSIVE, que tem um milhão de textos curtos traduzidos em 52 idiomas. Para transmitir o mesmo significado, alguns idiomas exigem muito mais tokens:
- Inglês: média de 7 tokens.
- Hindi: média de 32 tokens.
- Birmanês: média de 72 tokens, dez vezes mais que o inglês.
Se gerar um token leva o mesmo tempo em qualquer idioma, o GPT-4 é umas dez vezes mais lento em birmanês. E numa API que cobra por token, também é dez vezes mais caro.
Por isso surgiram modelos focados em outros idiomas. O mais ativo além do inglês é o chinês, com ChatGLM, YAYI, Llama-Chinese e outros. Também tem modelo em francês (CroissantLLM), vietnamita (PhoGPT), árabe (Jais) e vários outros.
Transformers
Antes de treinar, é preciso decidir como o modelo vai ser: qual arquitetura seguir e quantos parâmetros ter. Isso afeta não só o que ele consegue fazer, mas também o quanto é fácil usar depois. Um modelo de 7 bilhões de parâmetros é muito mais fácil de colocar em produção do que um de 175 bilhões.
Hoje a arquitetura mais popular é a transformer. Para entender por que ela surgiu, vale olhar o problema que ela resolveu.
O problema do seq2seq
Antes do transformer, a referência era a arquitetura seq2seq (sequence to sequence), de 2014. Ela trouxe ganhos grandes em tradução automática e resumo, e em 2016 o Google colocou o seq2seq no Google Translate, com o que eles chamaram de maior melhoria na qualidade de tradução até então.
O seq2seq tem duas partes, ambas usando RNNs (redes neurais recorrentes):
- Um codificador, que lê a entrada token por token e gera um estado oculto final que representa tudo o que foi lido.
- Um decodificador, que gera a saída token por token, usando esse estado final e o token gerado anteriormente.
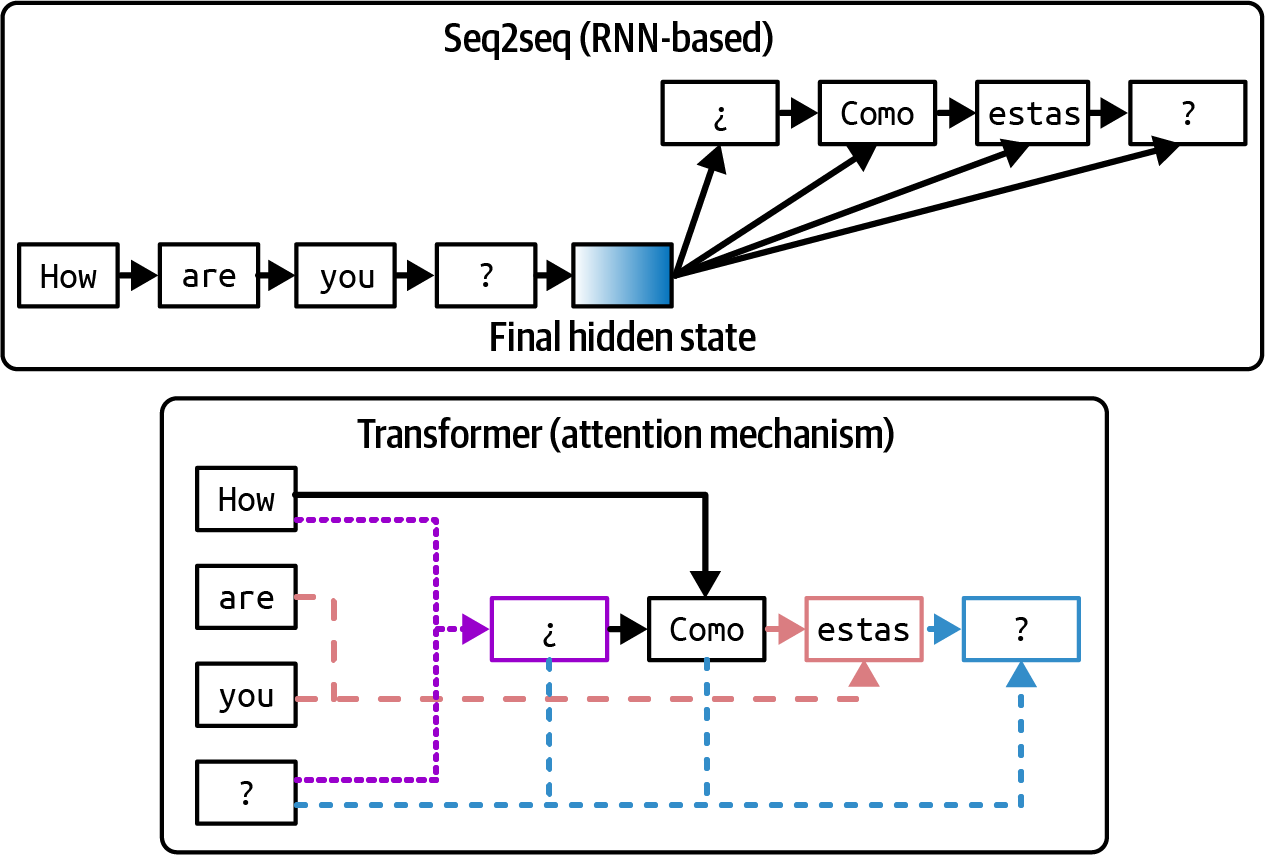
Isso tem dois problemas:
- O decodificador gera tudo a partir só do estado final da entrada. É como responder perguntas sobre um livro lendo apenas o resumo dele.
- Entrada e saída são processadas em sequência, um token de cada vez, o que deixa tudo lento para textos longos.
O transformer abandona as RNNs. Os tokens de entrada passam a ser processados em paralelo, o que acelera muito a leitura da entrada. A saída, porém, continua sendo gerada token a token nos modelos autorregressivos.
Mecanismo de atenção
O coração do transformer é o mecanismo de atenção. Ele usa três vetores:
- Consulta (Q, query): o que você está procurando.
- Chave (K, key): como o título de cada parte anterior do texto.
- Valor (V, value): o conteúdo daquela parte.
Uma analogia que me ajudou: imagine que você vai escrever o resumo de um livro e a sua pergunta é "o que o personagem aprendeu com tudo que passou?". Essa pergunta é o seu Q.
Você compara a pergunta com o título de cada capítulo (K) e dá uma nota de relevância para cada um. Os capítulos 2, 5 e 9 têm tudo a ver com o que você precisa, os outros nem tanto.
Depois você mistura o conteúdo (V) dos capítulos de forma proporcional a essas notas: o que importa mais pesa mais. O resultado dessa mistura é o que o modelo usa para gerar os próximos tokens, ou seja, o resumo.
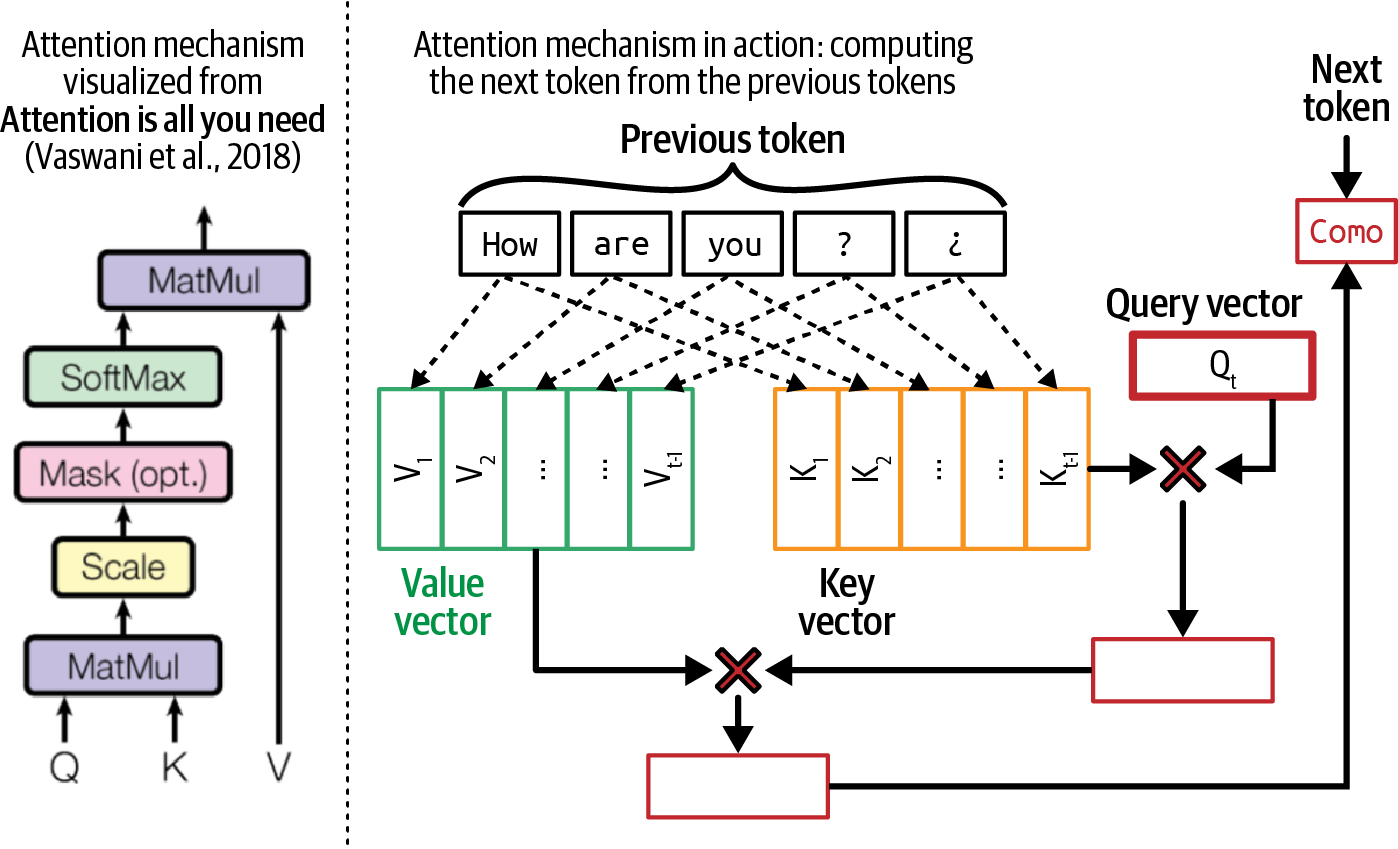
Como cada token anterior tem seu próprio vetor de chave e de valor, quanto maior a sequência, mais vetores precisam ser calculados e guardados. Esse é um dos motivos pelos quais aumentar o tamanho do contexto de um transformer é tão difícil.
Bloco transformador
Um transformer é formado por vários blocos empilhados. O conteúdo exato varia entre modelos, mas em geral cada bloco tem:
- Módulo de atenção: quatro matrizes de peso, uma para consulta, uma para chave, uma para valor e uma de projeção de saída.
- Módulo MLP (multi-layer perceptron): um conjunto de camadas que vão transformando a informação, uma depois da outra, de forma não linear.
O número de blocos é o que chamamos de camadas do modelo. Além deles, existem dois componentes nas pontas:
Antes dos blocos: o módulo de embedding. Ele tem a matriz de embedding e a matriz de embedding posicional, que transformam os tokens e as posições deles em vetores. De forma simplificada, o número de posições define o tamanho máximo do contexto: se o modelo acompanha 2.048 posições, o contexto máximo é 2.048 tokens. Existem técnicas para aumentar o contexto sem aumentar o número de posições, mas a ideia base é essa.
Depois dos blocos: a camada de saída. Ela transforma os vetores finais do modelo em probabilidades para cada token do vocabulário, que são usadas na amostragem. Tem gente que chama essa camada de cabeça (head) do modelo, já que é a última antes da saída.
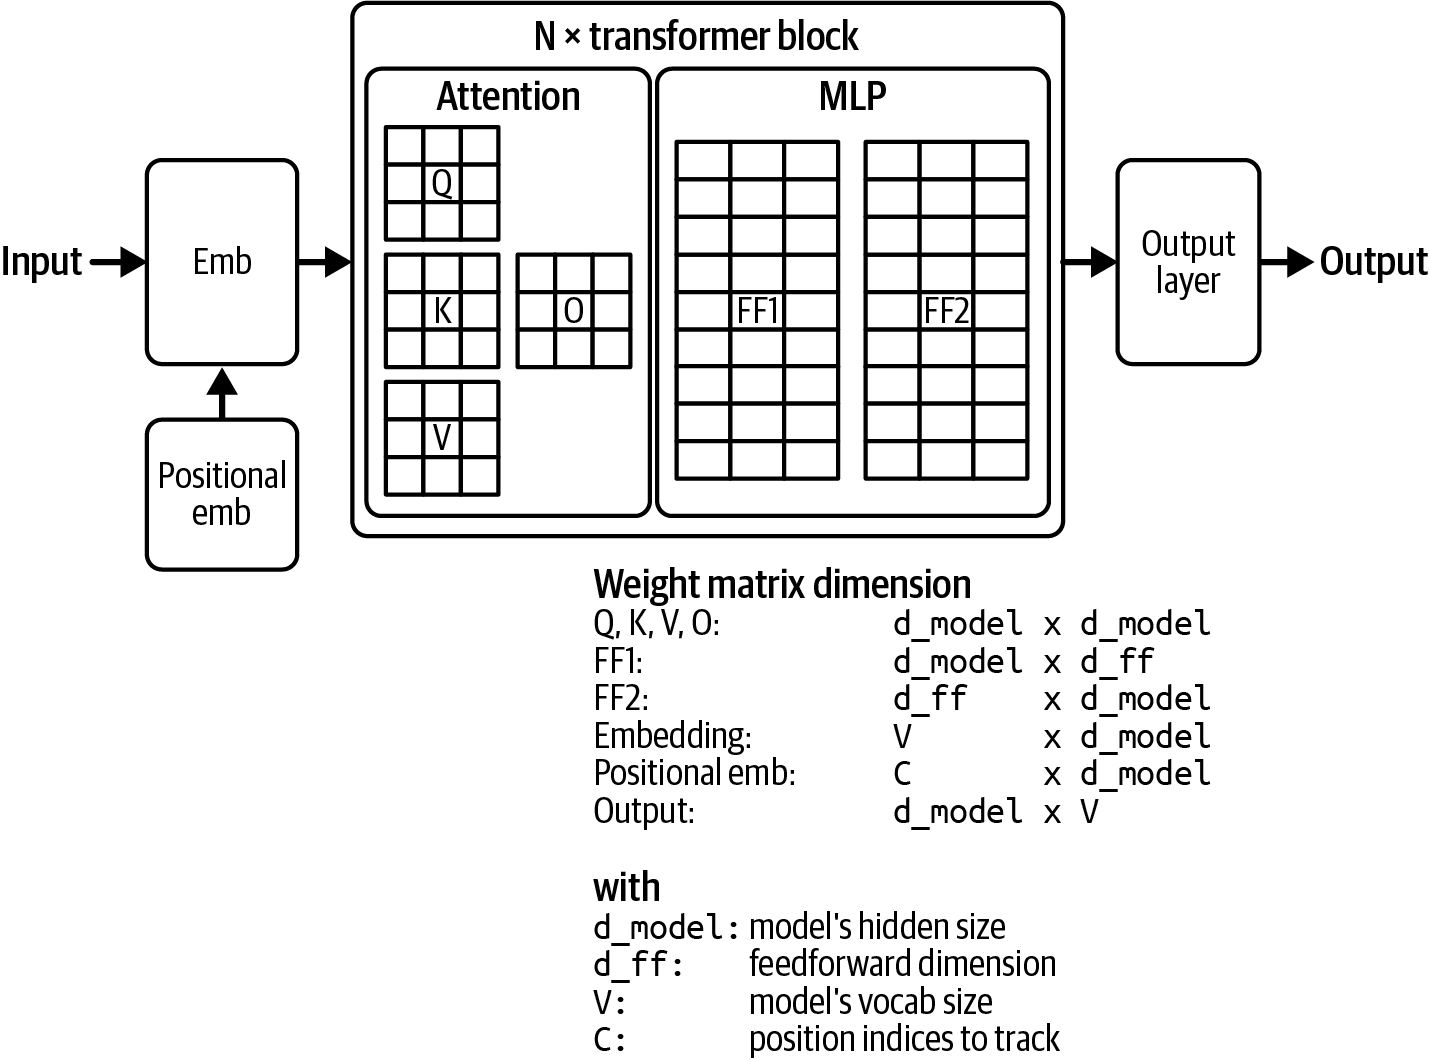
O tamanho de um transformer vem das dimensões dessas peças:
- A dimensão do modelo, que define o tamanho das matrizes de consulta, chave, valor e saída.
- O número de blocos.
- A dimensão da camada feedforward.
- O tamanho do vocabulário.
Contexto vs. blocos
Os blocos servem para encontrar relações no conteúdo e criar representações mais profundas. Uma forma simples de pensar:
- O contexto é a sua janela de visão, até onde você consegue enxergar.
- Os blocos são quantas rodadas de reflexão você faz sobre o que viu.
Se você dobrar os blocos sem aumentar o contexto, o modelo "pensa" melhor sobre o que já vê, mas continua sem enxergar mais tokens de uma vez.
Se aumentar o contexto sem aumentar os blocos, ele vê mais coisa de uma vez, mas pode não conseguir relacionar tudo isso com profundidade.
Contexto
No mundo dos LLMs, contexto é literalmente quanto texto, em tokens, o modelo consegue considerar de uma vez para gerar uma resposta coerente.
Por exemplo, o GPT-5 suporta 400 mil tokens no total, sendo 272 mil de entrada e 128 mil de saída. Esse é o limite que o modelo foi treinado para lidar. Se você passar disso, a API recusa a requisição com um erro de limite de tokens de entrada.
Algumas dicas práticas:
- Conte os tokens antes de enviar. Existem ferramentas para isso, e assim você garante que está dentro da janela de contexto.
- Divida conteúdos grandes. Para algo do tamanho de um livro, faça chamadas em sequência com blocos menores, gere o resumo de cada parte que interessa e, no final, faça uma única chamada juntando esses resumos.
No próximo artigo eu falo sobre tamanho de modelo: o que são parâmetros, quanto custa treinar um modelo desses e quais limites a escala está começando a encontrar.
Referência
Este artigo faz parte dos meus estudos sobre engenharia de IA, baseados no livro AI Engineering: Building Applications with Foundation Models, de Chip Huyen (O'Reilly, 2025). As imagens usadas aqui também vêm do livro.