RAG na prática: otimizando a recuperação
Busca híbrida, fragmentação, reranking, reescrita de consulta, recuperação contextual e RAG com imagens e tabelas.
Série · Parte 11 de 14 Engenharia de IA
- 01 De Sherlock ao GPT: a estatística por trás da linguagem 7 min
- 02 O que existe dentro de um modelo base 9 min
- 03 Parâmetros, computação e os limites da escala 8 min
- 04 Pós-treinamento e amostragem: por que a IA responde diferente a cada vez 9 min
- 05 Como medir um modelo: entropia, perplexidade e IA como juiz 10 min
- 06 Critérios de avaliação: sua IA realmente ajuda o negócio? 6 min
- 07 Escolhendo um modelo: API, código aberto e benchmarks 10 min
- 08 Do pipeline de avaliação ao primeiro prompt 11 min
- 09 Boas práticas de engenharia de prompt 9 min
- 10 RAG: dando contexto ao modelo 13 min
- 11 RAG na prática: otimizando a recuperação 9 min
- 12 Agentes: ferramentas e planejamento 13 min
- 13 Agentes: execução, falhas e memória 12 min
- 14 Arquitetura de uma aplicação de IA 11 min
Neste artigo13 seções
No artigo anterior vimos a arquitetura do RAG e os dois jeitos principais de recuperar informação: por termos e por embeddings. Cada um tem pontos fortes diferentes, então na prática quase ninguém usa só um. Aqui o foco é como combinar essas abordagens, como melhorar o que é recuperado e como levar o RAG para além do texto.
Combinando algoritmos de recuperação
Um sistema de recuperação em produção geralmente mistura várias abordagens. Quando você combina busca por termos com busca por embeddings, isso se chama busca híbrida.
Em sequência
Primeiro um recuperador barato e menos preciso, como a busca por termos, traz os candidatos. Depois um mecanismo mais preciso e mais caro, como o k-NN, escolhe os melhores entre esses candidatos. Essa segunda etapa é o reranking.
Exemplo: buscando por "transformer", você traz todos os documentos com essa palavra, sejam eles sobre transformador elétrico, arquitetura de rede neural ou o filme. Depois, com busca vetorial, filtra só os que realmente falam do que você quer.
Outro exemplo: "Quem é o responsável pelo maior número de vendas do produto X?". Primeiro você busca todos os documentos ligados a X pela palavra-chave. Depois usa a busca vetorial para encontrar o trecho que responde "quem vendeu mais".
Em paralelo
Também dá para rodar vários recuperadores ao mesmo tempo e juntar os rankings no final. Como cada recuperador ordena os documentos por relevância, você precisa de um jeito de combinar essas ordens.
Um algoritmo para isso é o RRF (reciprocal rank fusion, Cormack et al., 2009). Cada documento ganha uma pontuação de acordo com a posição em cada recuperador:
- Em 1º lugar: 1/1 = 1
- Em 2º lugar: 1/2 = 0,5
- E assim por diante.
A pontuação final é a soma de todos os recuperadores. Um documento que ficou em 1º em um e em 2º em outro soma 1 + 0,5 = 1,5. O RRF real tem alguns detalhes a mais, mas a ideia é essa.
Otimizando a recuperação
Algumas táticas aumentam a chance de os documentos certos serem encontrados. As principais são fragmentação, reranking, reescrita de consulta e recuperação contextual.
Fragmentação
Como os dados são indexados depende de como você vai buscá-los depois, e a estratégia de fragmentação (chunking) afeta muito o resultado.
A forma mais simples é dividir os documentos em partes iguais usando alguma unidade: caracteres, palavras, frases ou parágrafos. Por exemplo, blocos de 2.048 caracteres, de 512 palavras, de 20 frases ou um parágrafo por bloco.
Também dá para dividir de forma recursiva, usando unidades cada vez menores até caber no tamanho máximo. Começa dividindo por seções. Se uma seção for grande demais, divide em parágrafos. Se um parágrafo ainda for grande, divide em frases. Isso diminui a chance de separar textos que fazem sentido juntos.
Sem sobreposição entre os blocos, um corte pode cair bem no meio de uma ideia. Pense na frase "Deixei um bilhete para minha esposa" sendo cortada em "Deixei minha esposa" e "um bilhete". Nenhum dos dois pedaços transmite o que a frase original dizia. Com sobreposição, a informação da fronteira aparece em pelo menos um bloco. Com blocos de 2.048 caracteres, uma sobreposição de 20 caracteres pode ser um começo.
Alguns limites:
- O bloco não pode passar do contexto máximo do modelo generativo.
- Na busca por embeddings, também não pode passar do limite do modelo de embedding.
O tamanho do bloco é uma troca:
- Blocos menores trazem informação mais variada. Se você corta o tamanho pela metade, cabem o dobro de blocos no contexto, e o modelo tem mais material para responder.
- Mas blocos pequenos demais perdem informação. Se um documento fala do tópico X do começo ao fim, mas só cita X na primeira metade, a segunda metade pode nunca ser recuperada.
- E aumentam o custo computacional, principalmente com embeddings. Metade do tamanho significa o dobro de blocos para indexar, o dobro de embeddings para gerar e guardar e um espaço de busca duas vezes maior.
Não existe tamanho ideal universal, nem de bloco nem de sobreposição. Tem que testar.
Reranking
O ranking inicial do recuperador pode ser reavaliado para ficar mais preciso. Isso é útil principalmente quando você precisa reduzir a quantidade de documentos, seja para caber no contexto ou para gastar menos tokens.
O padrão mais comum é o que vimos na busca híbrida em sequência: um recuperador barato traz candidatos e um mecanismo mais caro reordena.
Também dá para ordenar por tempo, dando mais peso ao que é mais recente. Isso ajuda em aplicações sensíveis a data, como agregadores de notícias, chat com seus e-mails ou análise de mercado.
Tem uma diferença em relação à busca tradicional. Em um buscador, estar em 1º ou em 5º faz muita diferença. No contexto de um modelo, a ordem ainda importa (os modelos costumam aproveitar melhor o que está no começo e no fim do contexto), mas pesa menos. O mais importante é o documento estar lá.
Reescrita de consulta
Também chamada de reformulação, normalização ou expansão de consulta. Veja esta conversa:
Usuário: Quando foi a última vez que o John comprou algo da gente?
IA: O John comprou um chapéu há duas semanas, em 2 de janeiro de 2030.
Usuário: E a Emily Doe?
A última pergunta, sozinha, não faz sentido. Se você usar "E a Emily Doe?" literalmente para buscar documentos, vai trazer coisa irrelevante. A consulta precisa ser reescrita para funcionar sozinha: "Quando foi a última vez que a Emily Doe comprou algo da gente?".
Isso não é exclusivo do RAG. Buscadores tradicionais fazem reescrita com heurísticas. Em aplicações de IA, dá para usar outro modelo com um prompt como:
Dada a conversa abaixo, reescreva a última mensagem do usuário para que ela reflita o que ele está realmente perguntando e faça sentido sem o restante da conversa.Uma estratégia é utilizar modelos menores e mais baratos para identificar a intenção e definir níveis de contexto (primário, secundário etc.) para serem adicionados ao contexto principal passado para o modelo.
A reescrita pode ficar complicada quando exige resolver identidades ou buscar outras informações. Se o usuário pergunta "E a esposa dele?", primeiro você precisa consultar quem é a esposa. Se essa informação não existir, o modelo que reescreve deve reconhecer que não dá para resolver a consulta, em vez de inventar um nome e levar a uma resposta errada.
Recuperação contextual
A ideia é enriquecer cada bloco com contexto para que ele seja encontrado com mais facilidade.
O jeito mais simples é adicionar metadados, como tags e palavras-chave. Em um e-commerce, o produto pode levar junto a descrição e as avaliações. Imagens e vídeos podem ser buscados pelo título ou pela legenda.
Os metadados também podem ter entidades extraídas automaticamente do bloco. Se o documento cita o código de erro EADDRNOTAVAIL (99), colocar esse código nos metadados permite encontrar o documento por ele, mesmo depois de virar embedding.
Outra opção é adicionar ao bloco as perguntas que ele responde. No suporte, o artigo de como redefinir a senha pode vir com "Como redefinir a senha?", "Esqueci minha senha", "Não consigo fazer login" e até "Socorro, não acho minha conta".
Uma técnica é utilizar um modelo de IA para extrair palavras-chave do bloco, ou utilizar ferramentas para resumir o conteúdo.
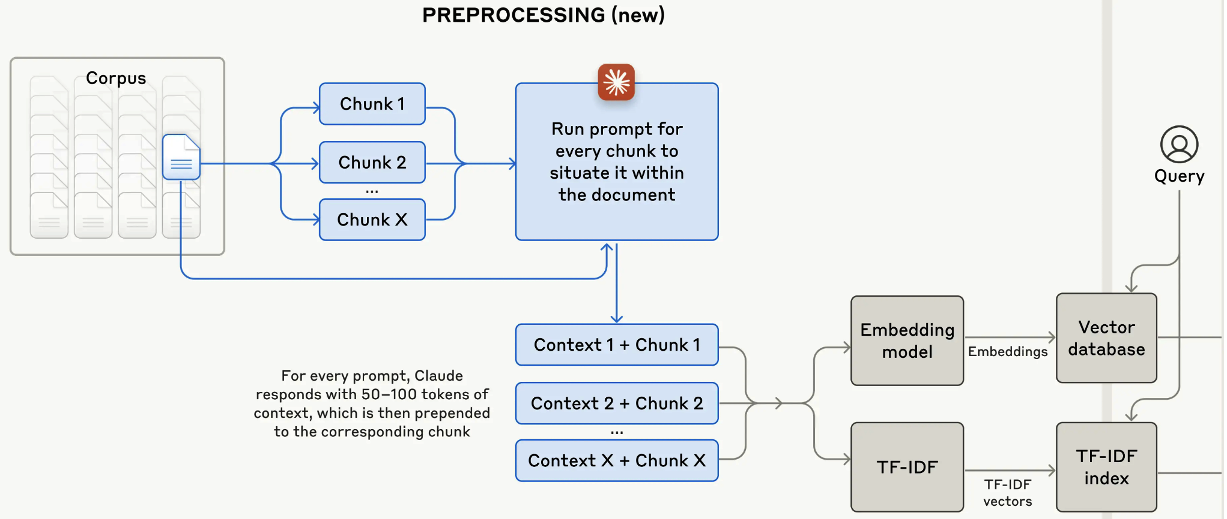
Quando um documento é dividido em vários blocos, alguns ficam sem o contexto necessário para o recuperador entender do que se trata. Para resolver, você pode acrescentar a cada bloco informações do documento original, como título e resumo.
A Anthropic fez isso usando um modelo para gerar um contexto curto, de 50 a 100 tokens, explicando o bloco e como ele se relaciona com o documento. Esse contexto é colocado antes do bloco, e o bloco enriquecido é que vai para a indexação.
Escolhendo uma solução de recuperação
Algumas perguntas que ajudam na hora de avaliar uma ferramenta:
- Quais mecanismos de recuperação ela suporta? Tem busca híbrida?
- Se for um banco vetorial, quais modelos de embedding e algoritmos de busca ela suporta?
- Como ela escala, em volume de dados e em tráfego de consultas? Aguenta o seu padrão de uso?
- Quanto tempo leva para indexar os dados? Quanto dá para inserir ou remover de uma vez?
- Qual a latência de consulta para cada algoritmo?
- Se for gerenciada, como é o preço? Por volume de documentos e vetores ou por volume de consultas?
E ainda tem os requisitos de empresa, como controle de acesso, conformidade e separação entre plano de dados e plano de controle.
RAG além do texto
Até aqui as fontes externas eram documentos de texto. Mas elas também podem ser imagens, vídeos, áudio e tabelas.
RAG multimodal
Se o gerador for multimodal, o contexto pode receber imagens, vídeos e áudio além de texto. Para a pergunta "Qual é a cor da casa do filme Up, da Pixar?", o recuperador pode trazer uma imagem da casa para o modelo responder.
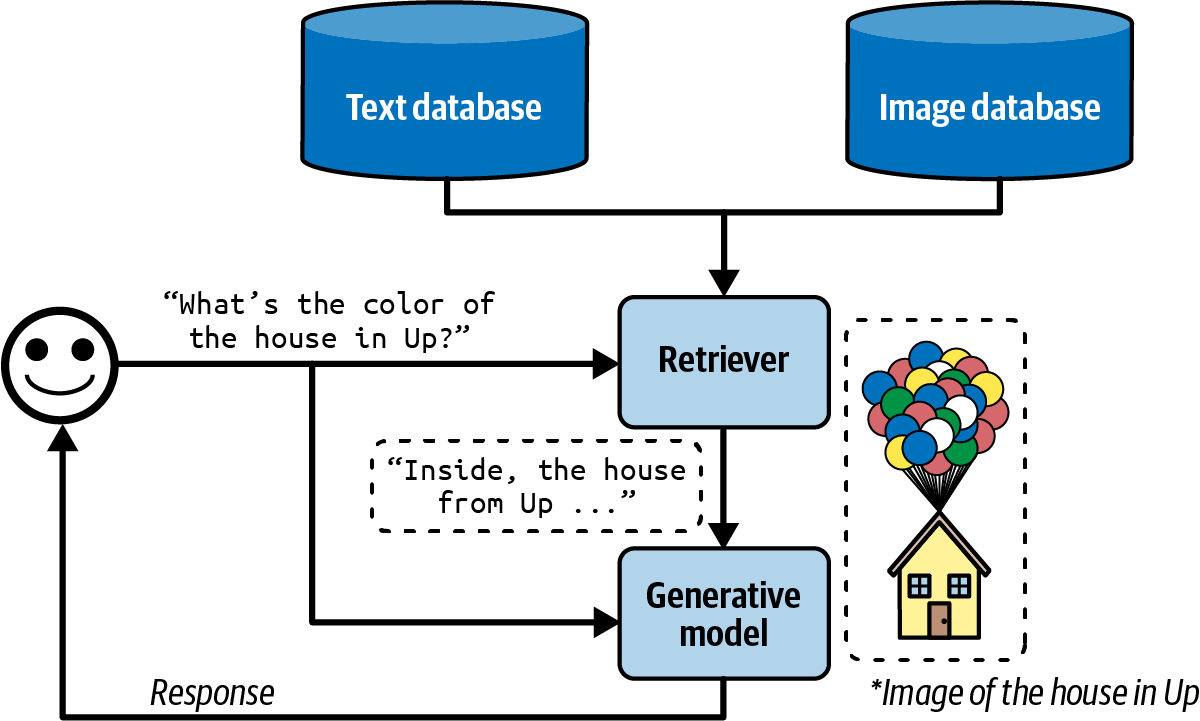
Se as imagens têm metadados, como título, tags e legenda, dá para buscar por eles. Uma imagem é recuperada quando a legenda é relevante para a consulta.
Para buscar pelo conteúdo da imagem, você precisa comparar imagens com consultas em texto. Para isso é preciso um modelo de embedding multimodal, que gere embeddings tanto para texto quanto para imagem, como o CLIP (Radford et al., 2021). O fluxo fica assim:
- Gere embeddings CLIP para todos os dados, textos e imagens, e guarde no banco vetorial.
- Quando chegar uma consulta, gere o embedding CLIP dela.
- Busque no banco os textos e imagens com embeddings mais próximos da consulta.
RAG com dados tabulares
Muitas aplicações trabalham com dados em tabelas, e várias perguntas só podem ser respondidas consultando essas tabelas. O fluxo aqui é bem diferente do RAG clássico.
Imagine um e-commerce de moda para gatos, a Kitty Vogue, com uma tabela de vendas chamada Sales:
| ID do pedido | Data e hora | ID do produto | Produto | Preço unitário ($) | Unidades | Total |
|---|---|---|---|---|---|---|
| 1 | ... | 2044 | Meow Mix Seasoning | 10.99 | 1 | 10.99 |
| 2 | ... | 3492 | Purr & Shake | 25 | 2 | 50 |
| 3 | ... | 2045 | Fruity Fedora | 18 | 1 | 18 |
Para responder "Quantas unidades do Fruity Fedora foram vendidas nos últimos 7 dias?", o sistema precisa buscar todos os pedidos desse produto e somar as unidades. Em SQL, ficaria algo assim:
SELECT SUM(units) AS total_units_sold
FROM Sales
WHERE product_name = 'Fruity Fedora'
AND timestamp >= DATE_SUB(CURDATE(), INTERVAL 7 DAY);
Então o sistema precisa:
- Text-to-SQL: a partir da pergunta e do esquema das tabelas, descobrir qual consulta SQL fazer. É um tipo de análise semântica.
- Executar o SQL.
- Gerar a resposta usando o resultado da consulta e a pergunta original.
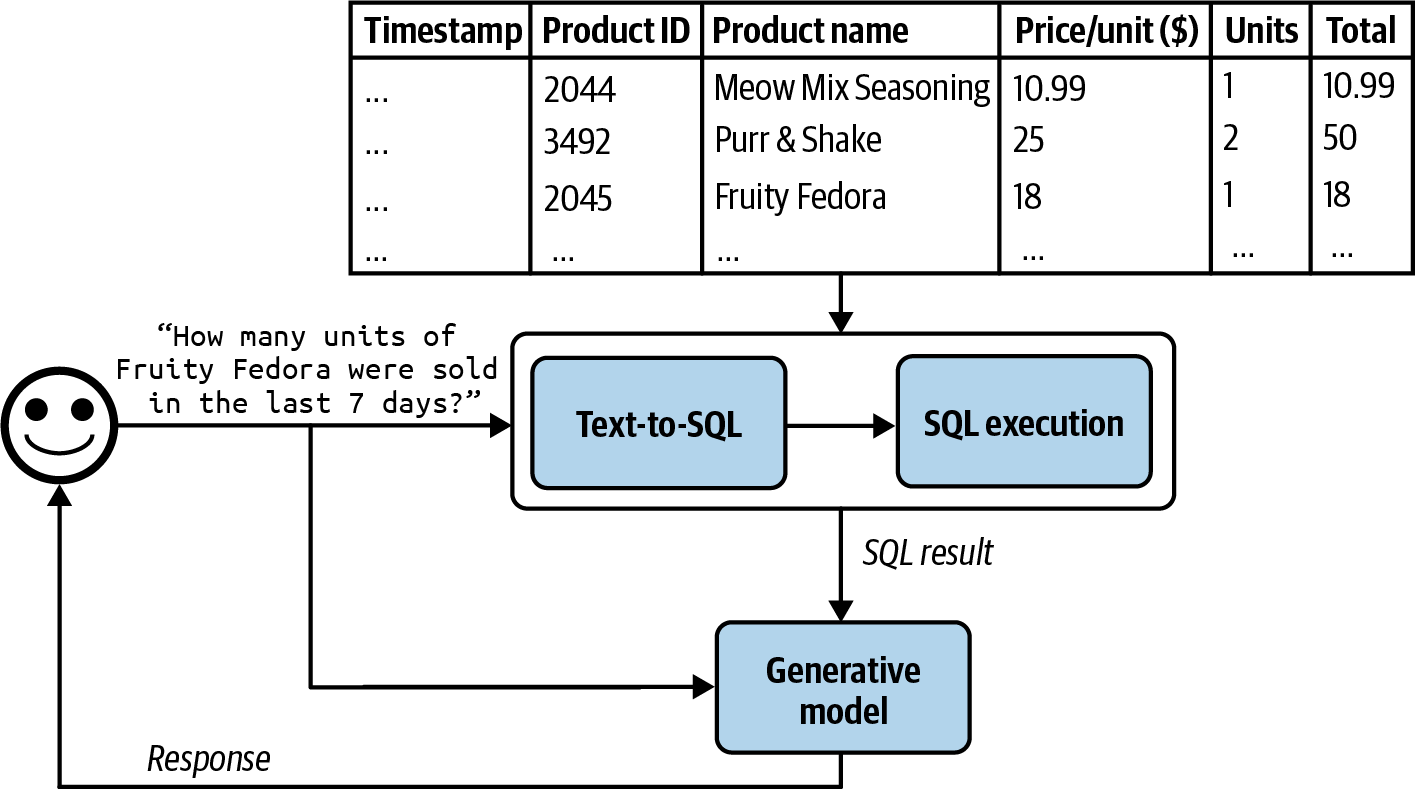
Se existirem muitas tabelas e os esquemas não couberem no contexto, pode ser necessária uma etapa antes para prever quais tabelas usar em cada consulta.
Gerar e executar SQL a partir de texto já é o modelo agindo sobre um sistema, e isso leva direto ao próximo assunto da série: agentes.
Referência
Este artigo faz parte dos meus estudos sobre engenharia de IA, baseados no livro AI Engineering: Building Applications with Foundation Models, de Chip Huyen (O'Reilly, 2025). As imagens usadas aqui também vêm do livro.