Arquitetura de uma aplicação de IA
Como uma aplicação de IA cresce: contexto, guardrails, roteador, gateway, cache, orquestração e feedback do usuário.
Série · Parte 14 de 14 Engenharia de IA
- 01 De Sherlock ao GPT: a estatística por trás da linguagem 7 min
- 02 O que existe dentro de um modelo base 9 min
- 03 Parâmetros, computação e os limites da escala 8 min
- 04 Pós-treinamento e amostragem: por que a IA responde diferente a cada vez 9 min
- 05 Como medir um modelo: entropia, perplexidade e IA como juiz 10 min
- 06 Critérios de avaliação: sua IA realmente ajuda o negócio? 6 min
- 07 Escolhendo um modelo: API, código aberto e benchmarks 10 min
- 08 Do pipeline de avaliação ao primeiro prompt 11 min
- 09 Boas práticas de engenharia de prompt 9 min
- 10 RAG: dando contexto ao modelo 13 min
- 11 RAG na prática: otimizando a recuperação 9 min
- 12 Agentes: ferramentas e planejamento 13 min
- 13 Agentes: execução, falhas e memória 12 min
- 14 Arquitetura de uma aplicação de IA 11 min
Neste artigo14 seções
Depois de passar por modelos, avaliação, prompt, RAG e agentes, falta juntar tudo. Uma aplicação de IA completa pode ficar bem complexa, mas ela não nasce assim. O caminho mais saudável é começar com a arquitetura mais simples possível, só a consulta indo para o modelo e a resposta voltando, e ir adicionando componentes conforme a necessidade aparece.
Apesar de existirem aplicações de IA de todo tipo, elas compartilham muitos componentes. A ordem que eu sigo neste artigo é mais ou menos esta:
- Melhorar o contexto que chega ao modelo, dando acesso a fontes de dados e ferramentas.
- Colocar barreiras de proteção para proteger o sistema e os usuários.
- Adicionar roteador e gateway de modelos para suportar pipelines mais complexos e ganhar segurança.
- Reduzir latência e custo com cache.
- Adicionar lógica mais complexa e ações de escrita para aproveitar todo o potencial do sistema.
Melhorar o contexto
O primeiro passo quase sempre é dar ao sistema uma forma de montar o contexto que o modelo precisa para responder cada consulta. É aqui que entram RAG, agentes e reescrita de consultas, que vimos nos artigos anteriores.
Eu gosto de pensar que construir contexto é a engenharia de features dos modelos de fundação. É o que entrega ao modelo a informação necessária para gerar uma boa resposta. Por ser tão central para a qualidade, quase todo provedor de API suporta isso de alguma forma: OpenAI, Claude e Gemini deixam você enviar arquivos e usar ferramentas.
Barreiras de proteção
As barreiras de proteção (guardrails) reduzem riscos e protegem você e seus usuários. A regra é simples: onde houver exposição a risco, coloque uma. Em geral elas ficam em dois lugares, na entrada e na saída.
Na entrada
Os guardrails de entrada costumam proteger contra dois riscos:
- Vazamento de informação privada para APIs externas. Um exemplo comum é mascarar dados pessoais (PII) antes de enviar a consulta para o modelo.
- Prompts maliciosos que tentam comprometer o sistema, como prompt injection e jailbreak.
Dá para reduzir esses riscos, mas não dá para zerar. Faz parte da natureza de como os modelos geram respostas, e as falhas humanas também sempre vão existir.
Na saída
Um modelo pode falhar de muitos jeitos. Os guardrails de saída têm duas funções:
- Detectar as falhas na resposta (conteúdo tóxico, informação inventada, formato quebrado).
- Definir a política para cada tipo de falha: tentar de novo, devolver uma resposta padrão, encaminhar para uma pessoa.
Os provedores de modelos já colocam guardrails nos próprios modelos, mas eles precisam equilibrar segurança e flexibilidade. Restrição demais deixa o modelo mais seguro e, ao mesmo tempo, menos útil para alguns casos. Por isso você também precisa das suas próprias barreiras, pensadas para o seu produto.
Roteador e gateway
Conforme a aplicação cresce e passa a usar mais de um modelo, aparecem dois componentes para controlar a complexidade e o custo: o roteador e o gateway.
Roteador
Em vez de mandar todas as consultas para o mesmo modelo, você pode ter soluções diferentes para tipos diferentes de consulta. Isso traz dois ganhos:
- Modelos especializados, que podem ir melhor do que um modelo geral em consultas específicas. Um para suporte técnico, outro para cobrança.
- Economia, mandando consultas simples para modelos mais baratos e deixando o modelo caro só para o que precisa dele.
Normalmente o roteador é um classificador de intenção, o mesmo conceito que apareceu nos artigos de agentes. Num chatbot de suporte, por exemplo:
- Se o usuário quer redefinir a senha, mande para a página de perguntas frequentes sobre recuperação de senha.
- Se quer corrigir um erro de cobrança, mande para um atendente humano.
- Se tem um problema técnico, mande para um chatbot especializado em suporte técnico.
O classificador também evita conversas fora do escopo. Se a consulta não tem nada a ver com o produto, o chatbot recusa com uma resposta padrão, sem gastar uma chamada de API. Se o usuário pergunta em quem o bot votaria na próxima eleição, ele pode responder algo como: "Como chatbot, eu não voto. Se tiver dúvidas sobre nossos produtos, posso ajudar."
Roteadores também ajudam o modelo a decidir o próximo passo:
- Num agente com várias ações, o roteador pode prever a próxima ação: usar o interpretador de código ou a API de busca?
- Num sistema com memória, ele pode prever de qual memória buscar informação. Se o usuário anexou um documento que fala de Melbourne e depois pergunta "Qual é o animal mais bonito de Melbourne?", o sistema precisa decidir entre confiar no documento ou buscar na internet.
Outro cuidado é o tamanho do contexto. Imagine uma consulta de 1.000 tokens roteada para um modelo com limite de 4K. Aí o sistema faz uma busca na web que devolve 8.000 tokens. Você pode cortar o contexto para caber no modelo escolhido ou rotear a consulta para um modelo com contexto maior.
O roteamento normalmente acontece antes da recuperação: decidir se a consulta está no escopo e se precisa buscar informação. Mas também pode acontecer depois, por exemplo para decidir se a consulta vai para um atendente humano.
Gateway
O gateway de modelos é uma interface única para falar com modelos diferentes, sejam hospedados por você ou de APIs comerciais. Se a API de um provedor muda, você atualiza só o gateway, e não todas as aplicações que usam aquela API.
Na forma mais simples, ele é só um wrapper. O código abaixo dá uma ideia de como seria, sem tratamento de erro nem otimização:
import os

import google.generativeai as genai
from flask import Flask, jsonify, request
from openai import OpenAI

app = Flask(__name__)


def openai_model(input_data, model_name, max_tokens):
    client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
    response = client.chat.completions.create(
        model=model_name,
        messages=[{"role": "user", "content": input_data}],
        max_tokens=max_tokens,
    )
    return {"response": response.choices[0].message.content}


def gemini_model(input_data, model_name, max_tokens):
    genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
    model = genai.GenerativeModel(model_name=model_name)
    response = model.generate_content(
        input_data,
        generation_config={"max_output_tokens": max_tokens},
    )
    return {"response": response.text}


@app.route("/model", methods=["POST"])
def model_gateway():
    data = request.get_json()
    model_type = data.get("model_type")
    model_name = data.get("model_name")
    input_data = data.get("input_data")
    max_tokens = data.get("max_tokens")

    if model_type == "openai":
        result = openai_model(input_data, model_name, max_tokens)
    elif model_type == "gemini":
        result = gemini_model(input_data, model_name, max_tokens)
    return jsonify(result)
Além de unificar a interface, o gateway resolve outros problemas:
- Controle de acesso e custo. Em vez de espalhar o token da organização para todo mundo que precisa da API (e correr o risco de vazar), você dá acesso só ao gateway. Ele vira um ponto central e controlado, define quem pode usar qual modelo e monitora e limita as chamadas para evitar abuso.
- Fallback. Quando a API principal cai ou estoura o limite de requisições (e isso acontece bastante), o gateway manda a requisição para outro modelo, tenta de novo depois de um tempo ou trata a falha de outra forma. A aplicação continua funcionando.
- Privacidade. Dá para direcionar consultas com informação sensível para um modelo hospedado por você.
- Logs. Tudo passa por um lugar só, então fica fácil registrar.
Como um gateway é relativamente simples de construir, existem várias opções prontas, como o AI Gateway da Portkey, o MLflow AI Gateway, o TrueFoundry, o Kong e o Cloudflare.
Cache para reduzir latência
Cache sempre foi uma forma de reduzir latência e custo em software, e muitas dessas ideias servem para aplicações de IA. Existem dois tipos principais: o cache exato e o cache semântico.
Cache exato
No cache exato, um item só é reaproveitado quando exatamente aquele item é pedido de novo. Se um usuário pede o resumo de um produto, o sistema verifica se já existe um resumo daquele produto no cache. Se existir, devolve. Se não, gera o resumo e guarda.
Ele também é usado na recuperação por embeddings, para evitar buscas vetoriais repetidas: se a consulta já está no cache, devolve o resultado guardado.
O cache vale ainda mais a pena para consultas com várias etapas (como cadeia de raciocínio) ou com ações demoradas (recuperação, SQL, busca na web).
Ele pode ficar em memória para ser rápido, mas memória é limitada. Por isso também dá para usar PostgreSQL, Redis ou um armazenamento em camadas para equilibrar velocidade e capacidade. E é importante ter uma política de remoção para controlar o tamanho do cache. As mais comuns são:
- LRU (Least Recently Used): remove o que foi usado há mais tempo.
- LFU (Least Frequently Used): remove o que é usado com menos frequência.
- FIFO (First In, First Out): remove o que entrou primeiro.
Quanto tempo manter uma consulta no cache depende da chance de ela ser feita de novo. Consultas específicas do usuário, como "Qual é o status do meu último pedido?", dificilmente serão repetidas por outra pessoa, então não deveriam ir para o cache. O mesmo vale para consultas que dependem do momento, como "Como está o tempo?". Muitos times treinam um classificador só para decidir se uma consulta deve ou não ser cacheada.
Cache mal feito pode vazar dados. Imagine uma loja online em que o usuário X pergunta algo que parece genérico: "Qual é a política de devolução de eletrônicos?". Como a política depende do plano de cada usuário, o sistema busca os dados de X e gera uma resposta com informações dele. Se o sistema tratar essa pergunta como genérica e guardar a resposta no cache, quando o usuário Y fizer a mesma pergunta vai receber a resposta com os dados de X.
Cache semântico
No cache semântico, a resposta guardada é reaproveitada mesmo quando a nova consulta é só parecida, e não idêntica. Se alguém pergunta "Qual é a capital do Vietnã?" e o modelo responde "Hanói", depois outra pessoa pergunta "Qual a capital do Vietnã?" e o sistema reaproveita a mesma resposta.
Isso aumenta a taxa de acerto do cache e pode reduzir custo, mas também pode piorar a qualidade das respostas, porque nem toda consulta parecida tem a mesma resposta.
Ele só funciona se você tiver uma forma confiável de dizer que duas consultas são parecidas. O jeito mais comum é por similaridade semântica:
- Gerar o embedding de cada consulta com um modelo de embeddings.
- Fazer uma busca vetorial para achar o embedding em cache mais parecido com o da consulta atual. Digamos que a similaridade seja X.
- Se X passar de um limite definido, devolver o resultado em cache. Se não, processar a consulta e guardar o resultado junto com o embedding.
Para isso você vai precisar de um banco vetorial guardando os embeddings das consultas em cache.
Padrões de agente
Com o tempo, o fluxo da aplicação deixa de ser uma linha reta e passa a ter loops, execução paralela e decisões condicionais. É aí que os padrões de agente ajudam.
Um exemplo: o sistema gera uma resposta, avalia e percebe que não cumpriu a tarefa porque faltou informação. Ele faz uma nova recuperação, junta a resposta original com o contexto novo e manda de novo para o mesmo modelo ou para outro. Isso cria um loop.
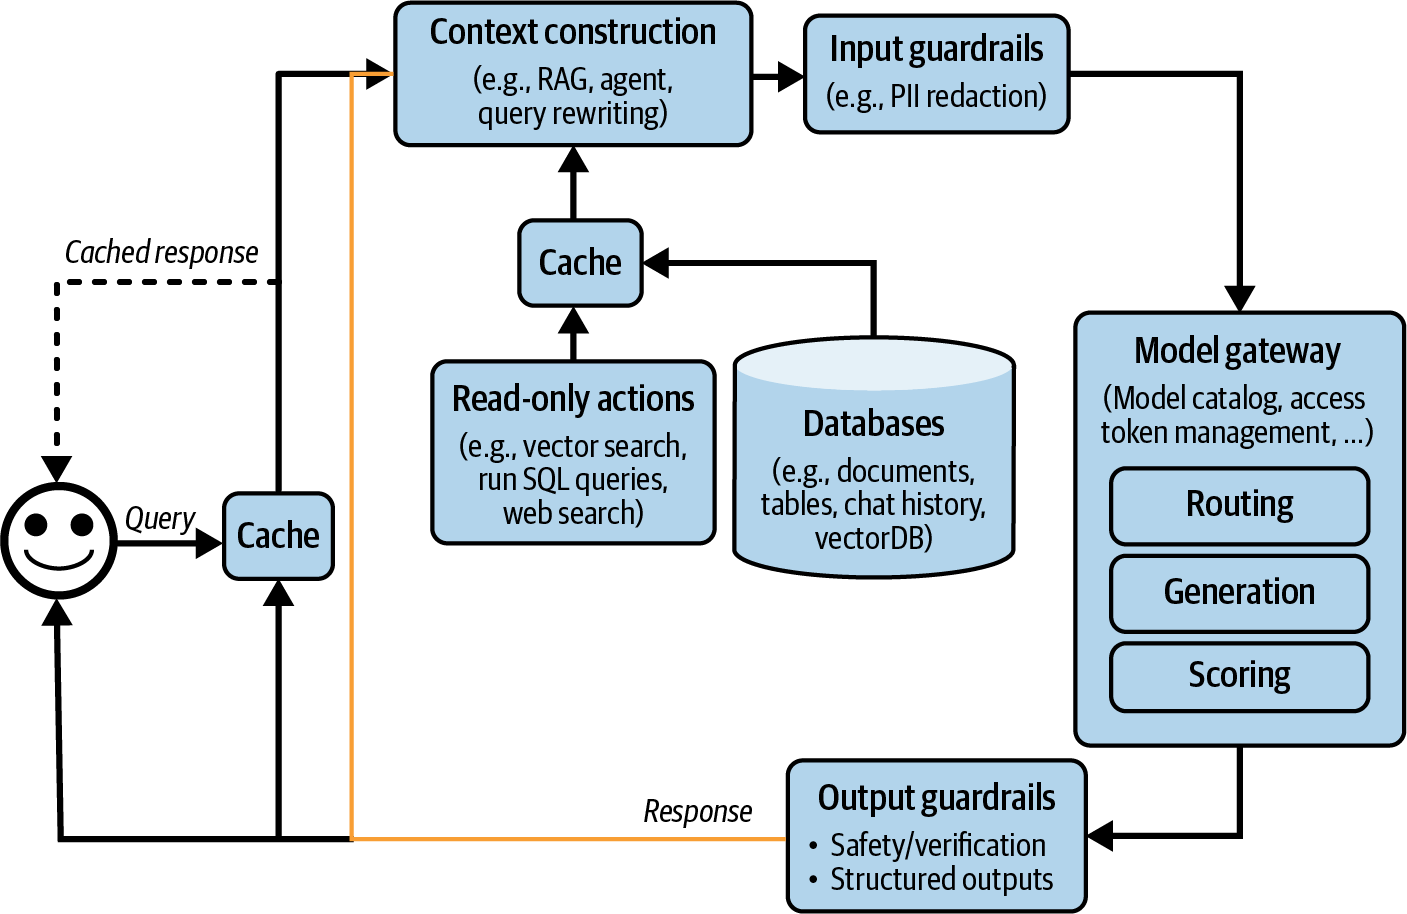
Também é aqui que entram as ações de escrita, como enviar um e-mail, atualizar um banco ou fazer um pedido. Elas aumentam muito o que o sistema consegue fazer, e por isso mesmo pedem mais cuidado com permissões e aprovação humana, como vimos nos artigos de agentes.
Orquestração do pipeline
Uma aplicação de IA pode acabar com vários modelos, vários bancos de dados e um monte de ferramentas. Um orquestrador define como esses componentes trabalham juntos para formar um pipeline de ponta a ponta, garantindo que os dados passem de um para o outro sem problema.
Ele funciona em duas etapas:
- Definição dos componentes: você informa quais modelos, fontes de dados e ferramentas o sistema usa.
- Encadeamento: você descreve os passos desde a chegada da consulta até a conclusão da tarefa. No fundo é composição de funções. Por exemplo:
- Processar a consulta original.
- Recuperar os dados relevantes com base na consulta processada.
- Juntar a consulta e os dados recuperados num prompt no formato que o modelo espera.
- Gerar a resposta.
- Avaliar a resposta.
- Se estiver boa, devolver ao usuário. Se não, encaminhar para um atendente humano.
O orquestrador cuida da passagem de dados entre os componentes. Ele deve ajudar a garantir que a saída de uma etapa esteja no formato que a próxima espera, e o ideal é que ele avise quando o fluxo quebra, seja por falha de um componente ou por dados incompatíveis.
Existem várias ferramentas de orquestração, como LangChain, LlamaIndex, Flowise, Langflow e Haystack. Como recuperação e uso de ferramentas são padrões muito comuns, muitos frameworks de RAG e de agentes também funcionam como orquestradores.
Feedback do usuário
O feedback do usuário serve para personalizar o modelo para cada pessoa e também para treinar as próximas versões dele. Com dados públicos ficando cada vez mais escassos, dados próprios valem mais do que nunca. Um produto que chega cedo e conquista usuários consegue coletar dados para melhorar continuamente, e isso fica difícil de copiar.
Só não dá para esquecer que feedback é dado do usuário. Ele exige os mesmos cuidados de qualquer outro dado: respeitar a privacidade e deixar claro para o usuário como aquilo vai ser usado.
Com este artigo eu fecho a série. A ideia foi registrar o caminho que fiz estudando, desde como um modelo de linguagem prevê a próxima palavra até como montar uma aplicação inteira em volta dele. Muita coisa aqui vai mudar rápido, mas a base (contexto, avaliação, segurança e custo) tende a continuar valendo.
Referência
Este artigo faz parte dos meus estudos sobre engenharia de IA, baseados no livro AI Engineering: Building Applications with Foundation Models, de Chip Huyen (O'Reilly, 2025). As imagens usadas aqui também vêm do livro.