Agentes: execução, falhas e memória
Chamada de função, tipos de plano, reflexão, as falhas mais comuns de um agente, como ele guarda memória e onde entra o ajuste fino.
Série · Parte 13 de 14 Engenharia de IA
- 01 De Sherlock ao GPT: a estatística por trás da linguagem 7 min
- 02 O que existe dentro de um modelo base 9 min
- 03 Parâmetros, computação e os limites da escala 8 min
- 04 Pós-treinamento e amostragem: por que a IA responde diferente a cada vez 9 min
- 05 Como medir um modelo: entropia, perplexidade e IA como juiz 10 min
- 06 Critérios de avaliação: sua IA realmente ajuda o negócio? 6 min
- 07 Escolhendo um modelo: API, código aberto e benchmarks 10 min
- 08 Do pipeline de avaliação ao primeiro prompt 11 min
- 09 Boas práticas de engenharia de prompt 9 min
- 10 RAG: dando contexto ao modelo 13 min
- 11 RAG na prática: otimizando a recuperação 9 min
- 12 Agentes: ferramentas e planejamento 13 min
- 13 Agentes: execução, falhas e memória 12 min
- 14 Arquitetura de uma aplicação de IA 11 min
Neste artigo18 seções
- Chamada de função
- Granularidade do plano
- Planos que não são sequenciais
- Reflexão e correção de erros
- Escolhendo as ferramentas
- Onde o planejamento falha
- Falhas no uso de ferramentas
- Falhas no objetivo
- Erros de reflexão
- Como medir essas falhas
- Memória
- Os três tipos de memória
- Por que dar memória ao agente
- Gerenciando a memória
- Estratégias de remoção
- Ajuste fino
- Aprendizado por transferência
- Referência
No artigo anterior eu falei sobre o que é um agente, quais ferramentas ele pode usar e como ele gera um plano. Agora a ideia é ver o que acontece quando esse plano sai do papel: como o modelo chama as ferramentas, os tipos de plano, como o agente corrige os próprios erros, onde ele costuma falhar e como ele lembra das coisas.
Chamada de função
Hoje a maioria dos provedores de modelos oferece uso de ferramentas, o que na prática transforma o modelo em um agente. Como uma ferramenta é uma função, chamar uma ferramenta costuma ser chamado de chamada de função (function calling).
Cada API tem seu jeito, mas o fluxo geral é este:
- Criar o inventário de ferramentas. Você declara todas as ferramentas que o modelo pode usar. Cada uma tem um ponto de entrada (o nome da função), os parâmetros e uma documentação explicando o que ela faz e o que precisa receber.
- Dizer quais ferramentas o agente pode usar em cada consulta. Consultas diferentes precisam de ferramentas diferentes, então muitas APIs deixam você passar a lista por requisição. Algumas ainda permitem controlar o uso:
required: o modelo precisa usar pelo menos uma ferramenta.none: o modelo não deve usar nenhuma.auto: o modelo decide.
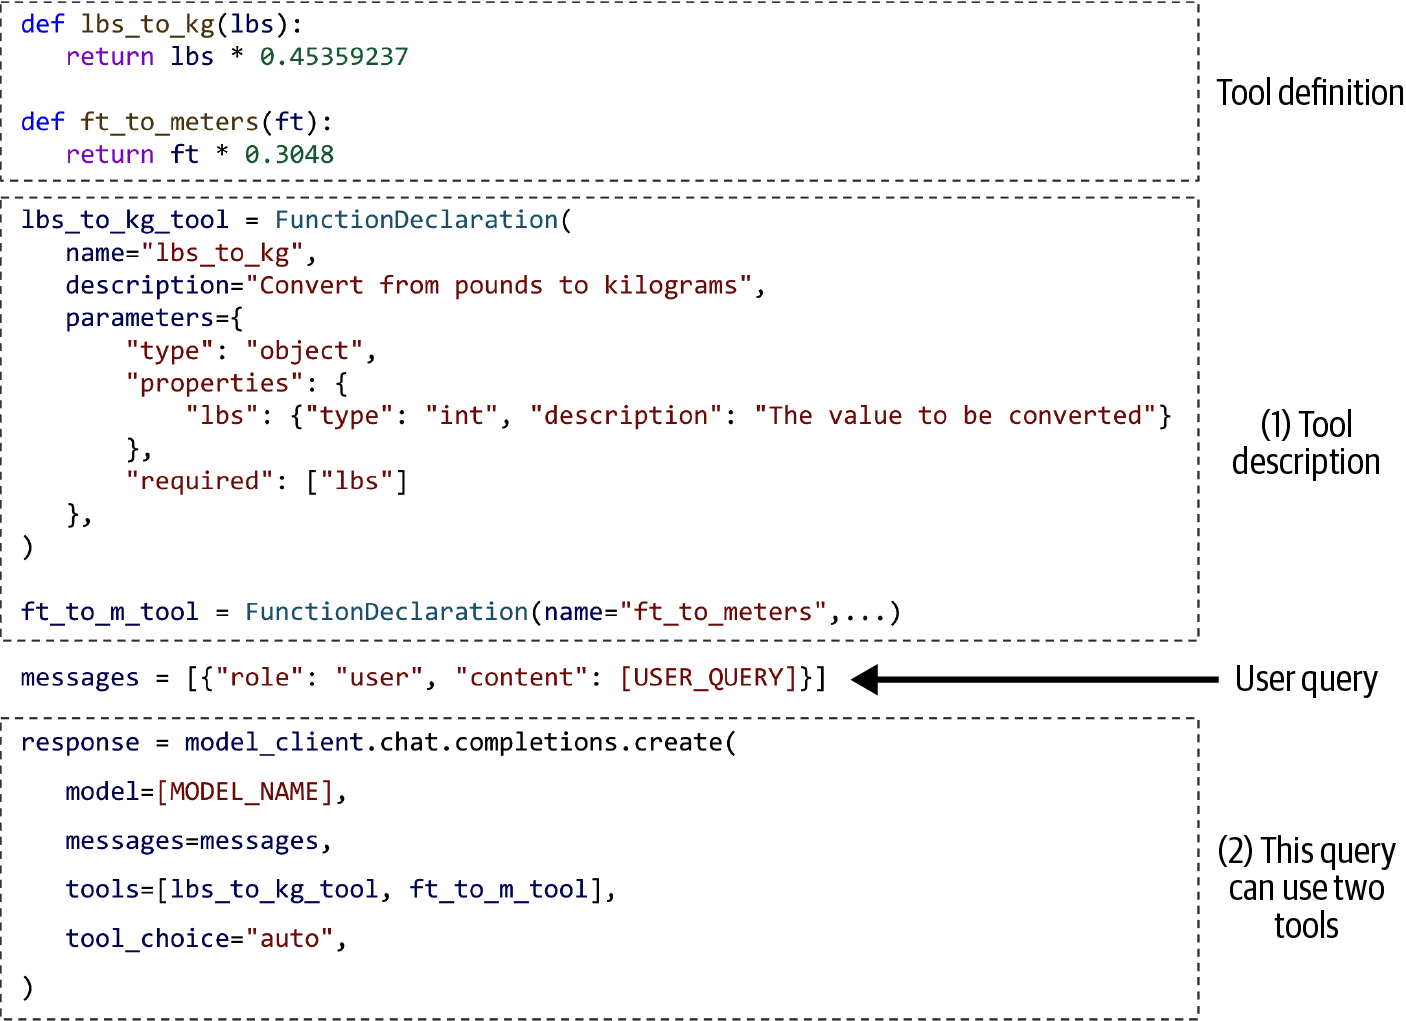
lbs_to_kg e ft_to_meters viram ferramentas descritas para o modelo, e a consulta pode usar as duas com tool_choice="auto".Repare que a descrição da ferramenta é o que o modelo "lê" para decidir se e como chamar a função. Uma descrição ruim leva a chamadas ruins.
Granularidade do plano
Um plano pode ter níveis diferentes de detalhe. Para planejar um ano, um plano por trimestre é mais alto nível do que um plano por mês, que é mais alto nível do que um plano por semana.
Aqui existe uma troca:
- Um plano detalhado é mais difícil de gerar, mas mais fácil de executar.
- Um plano de alto nível é mais fácil de gerar, mas mais difícil de executar.
Uma forma de contornar isso é planejar de forma hierárquica. Primeiro um planejador gera o plano de alto nível (os trimestres). Depois, para cada trimestre, o mesmo planejador ou outro gera o plano mês a mês.
Planos que não são sequenciais
Até aqui os planos foram sequenciais: uma ação depois da outra. A ordem em que as ações são executadas se chama fluxo de controle, e o sequencial é só um dos tipos:
- Sequencial: executa B depois que A termina, normalmente porque B depende de A.
- Paralelo: executa A e B ao mesmo tempo. Para "encontre os produtos mais vendidos abaixo de US$ 100", o agente busca os 100 mais vendidos e depois busca o preço de cada um em paralelo.
- If: executa B ou C dependendo do resultado anterior. O agente lê o relatório de resultados de uma empresa e decide comprar ou vender as ações.
- Loop: repete A até uma condição ser atendida. Por exemplo, gerar números aleatórios até sair um número primo.
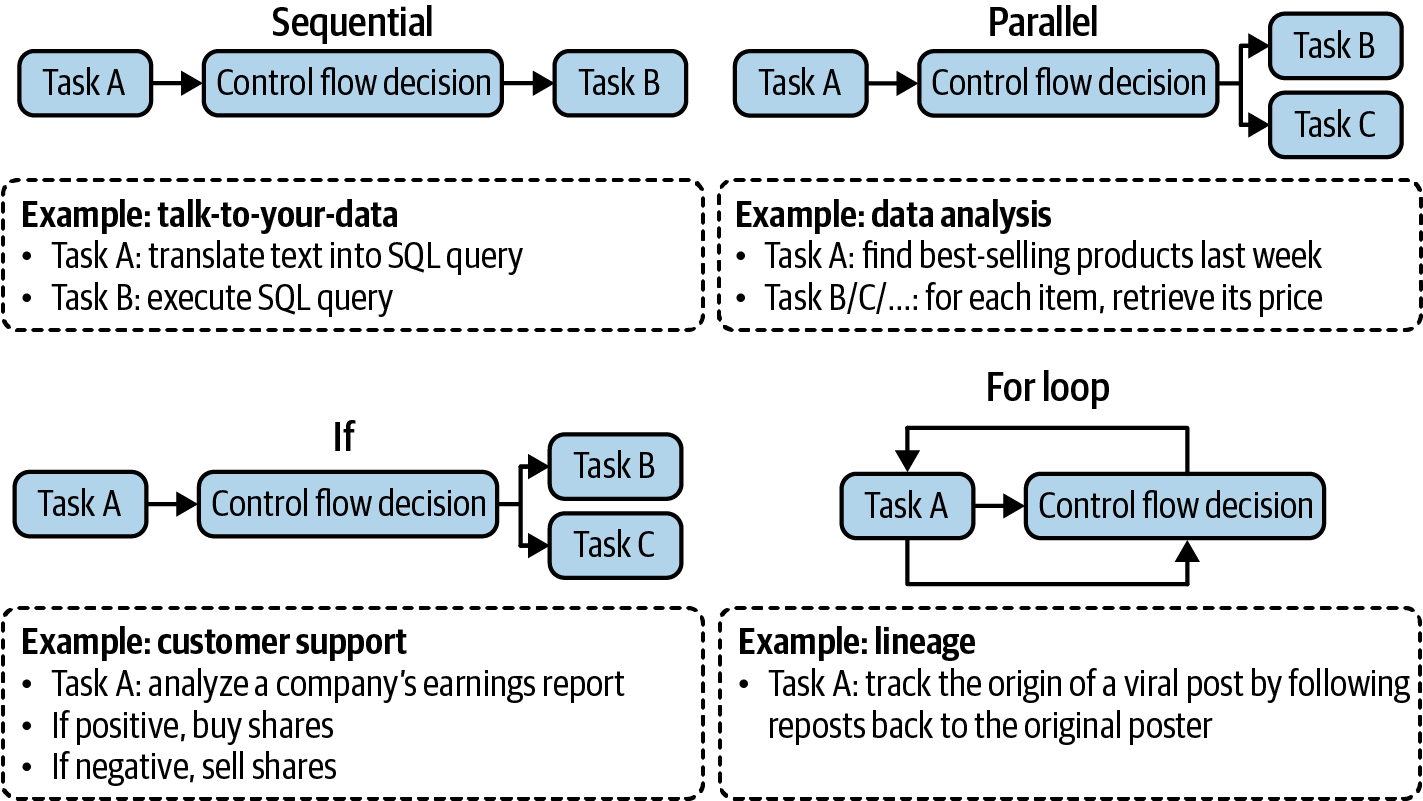
Na engenharia de software tradicional, as condições desses fluxos são exatas. Num agente, quem decide o fluxo é o modelo. E planos que não são sequenciais são mais difíceis de gerar e de transformar em comandos executáveis.
Ao escolher um framework de agentes, vale olhar quais fluxos ele suporta. Se o sistema precisa navegar em dez sites, ele consegue fazer isso ao mesmo tempo? Execução paralela reduz bastante a latência que o usuário sente.
Reflexão e correção de erros
Mesmo um bom plano precisa ser avaliado e ajustado o tempo todo. A reflexão não é obrigatória para o agente funcionar, mas é ela que faz o agente ter sucesso.
O padrão mais conhecido aqui é o ReAct, que intercala raciocínio e ação. A cada etapa o agente:
- Explica o que está pensando (planejamento).
- Executa uma ação.
- Analisa o que observou (reflexão).
E repete até considerar a tarefa concluída.
A reflexão também pode ser feita por outro agente: um planeja e executa, o outro avalia o resultado depois de cada etapa ou a cada algumas etapas.
Quando o agente falha, você pode pedir para ele refletir sobre o motivo e sobre como melhorar, e a partir disso gerar um novo plano. É assim que ele aprende com os próprios erros.
Um exemplo em geração de código: o avaliador mostra que o código falha em ⅓ dos testes. O agente reflete e percebe que não considerou arrays em que todos os números são negativos. Então gera um novo código tratando esse caso.
Escolhendo as ferramentas
As ferramentas pesam muito no sucesso de uma tarefa, então a escolha merece cuidado. Ela depende do ambiente e da tarefa, mas também do modelo que está por trás do agente.
Mais ferramentas significam mais capacidade, mas também mais dificuldade para usar tudo bem, do mesmo jeito que é difícil para uma pessoa dominar uma caixa de ferramentas enorme. E cada ferramenta nova aumenta as descrições que vão no contexto, que pode nem caber no limite do modelo.
Como quase tudo em IA, a escolha vem de experimento. Algumas coisas que ajudam:
- Comparar o desempenho do agente com conjuntos diferentes de ferramentas.
- Fazer um estudo de ablação: tirar uma ferramenta e ver o quanto o desempenho cai. Se não cair, pode remover.
- Olhar em quais ferramentas o agente erra com frequência. Se nem com um prompt caprichado nem com ajuste fino ele aprende a usar uma ferramenta, troque a ferramenta.
- Montar um gráfico com a distribuição das chamadas para ver quais ferramentas são mais e menos usadas.
Onde o planejamento falha
Planejar é difícil e dá errado de várias formas.
Falhas no uso de ferramentas
É o tipo mais comum. O plano pode ter:
- Ferramenta inválida: o plano chama
bing_search, mas essa ferramenta não está no inventário. - Ferramenta válida com parâmetros inválidos: chama
lbs_to_kgcom dois parâmetros, mas ela só recebe um,lbs. - Ferramenta válida com valores errados: chama
lbs_to_kgcomlbsigual a 100 quando deveria ser 120.
Falhas no objetivo
O agente não chega no objetivo, ou chega sem respeitar as restrições. Peça uma viagem de duas semanas de São Francisco para Hanói com US$ 5.000 e ele pode planejar uma viagem para Ho Chi Minh, ou planejar a viagem certa estourando o orçamento.
Uma restrição que quase sempre fica de fora da avaliação é o tempo. Em muitos casos tanto faz quanto o agente demora, você só confere quando terminar. Mas em outros, o resultado perde valor com o tempo: se você pede para o agente preparar uma proposta e ele termina depois do prazo de entrega, não adiantou nada.
Erros de reflexão
Esse é curioso: o agente tem certeza de que concluiu a tarefa, mas não concluiu. Você pede para distribuir 50 pessoas em 30 quartos de hotel, ele distribui só 40 e insiste que terminou.
Como medir essas falhas
Uma forma de avaliar é montar um conjunto de dados de planejamento, em que cada exemplo é uma tupla (tarefa, inventário de ferramentas). Para cada tarefa, o agente gera K planos, e você calcula:
- Dos planos gerados, quantos são válidos?
- Em média, quantos planos o agente precisa gerar até sair um válido?
- Das chamadas de ferramentas, quantas são válidas?
- Com que frequência ferramentas inválidas são chamadas?
- Com que frequência ferramentas válidas recebem parâmetros inválidos?
- Com que frequência ferramentas válidas recebem valores errados?
Depois procure padrões. Em quais tarefas o agente falha mais? Por quê? Com quais ferramentas ele erra mais? Dá para melhorar o uso de uma ferramenta difícil com prompt, exemplos ou ajuste fino. Se nada resolver, troque por uma mais fácil de usar.
Memória
Memória é o conjunto de mecanismos que permite ao modelo guardar e usar informações. Ela é especialmente útil em aplicações que dependem de muito conhecimento, como RAG, e em aplicações de várias etapas, como agentes.
Um agente precisa guardar instruções, exemplos, contexto, inventário de ferramentas, planos, saídas das ferramentas, reflexões e mais um monte de coisa. Mas qualquer aplicação de IA que precise reter informação se beneficia de memória.
Os três tipos de memória
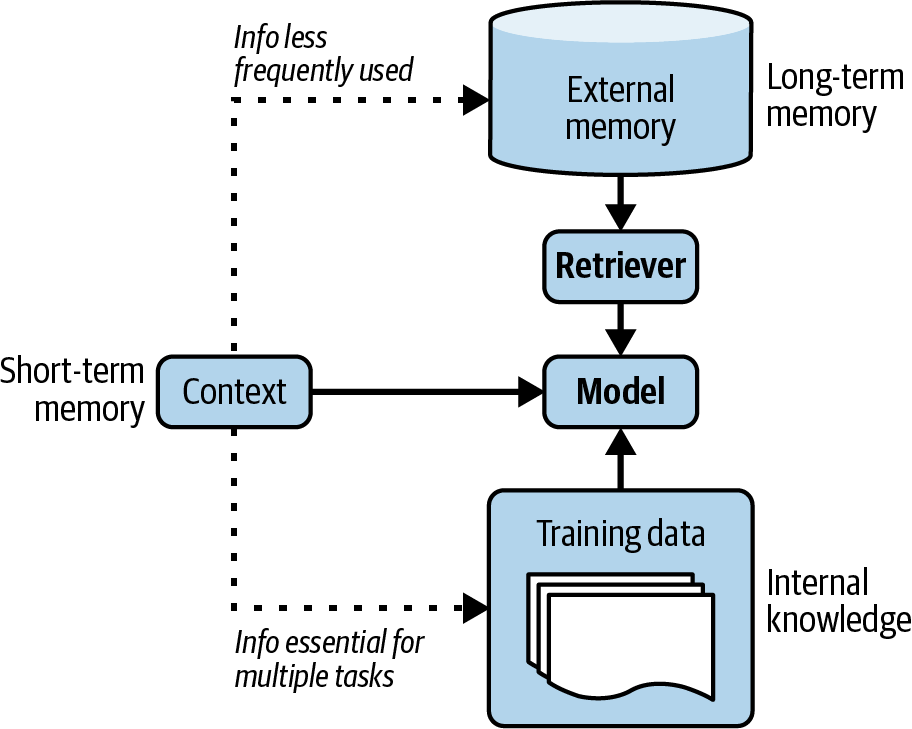
- Conhecimento interno. O próprio modelo é uma memória, porque guarda o que aprendeu no treinamento. Esse conhecimento só muda se o modelo for atualizado, e está disponível em todas as consultas.
- Memória de curto prazo. É o contexto do modelo. As mensagens anteriores da conversa entram no contexto e ajudam nas próximas respostas. O acesso é rápido, mas o espaço é limitado e não persiste entre tarefas, então deve guardar o que é mais importante para a tarefa atual.
- Memória de longo prazo. São as fontes externas que o modelo acessa por recuperação, como num sistema RAG. Ela persiste entre tarefas e pode ser apagada sem mexer no modelo.
A escolha de onde guardar cada informação depende da frequência de uso:
- O que é essencial para todas as tarefas vai para o conhecimento interno, via treinamento ou ajuste fino.
- O que é usado raramente fica na memória de longo prazo.
- A memória de curto prazo fica para o que é imediato e específico do momento.
Por que dar memória ao agente
- Lidar com excesso de informação numa sessão. Durante uma tarefa o agente acumula muita coisa nova, que pode passar do limite de contexto. O excesso vai para a memória de longo prazo.
- Manter informação entre sessões. Um assistente que esquece suas preferências toda vez é irritante. Com acesso ao histórico, ele personaliza as respostas. Se lembra que você adorou O Problema dos Três Corpos, consegue sugerir livros parecidos.
- Ser mais consistente. Se você me pede para dar uma nota de 1 a 5 para uma piada duas vezes, eu tendo a repetir a nota se lembrar da primeira. Com o modelo é igual: consultando respostas anteriores, ele calibra as próximas.
- Preservar a estrutura dos dados. Texto é desestruturado. Você até pode colocar uma tabela no contexto linha por linha, mas não há garantia de que o modelo entenda que aquilo é uma tabela. Uma memória que guarda dados estruturados resolve isso. Um agente que busca oportunidades de venda pode guardar tudo numa planilha, ou usar uma fila para a sequência de ações.
Gerenciando a memória
Um sistema de memória tem duas funções:
- Gerenciamento: decidir o que fica na memória de curto prazo e o que vai para a de longo prazo.
- Recuperação: buscar na memória de longo prazo o que é relevante para a tarefa. Funciona bem parecido com a recuperação do RAG.
O gerenciamento basicamente adiciona e remove memórias. Na memória de longo prazo dá para quase não apagar nada, porque armazenamento externo é barato e cresce fácil. Já a de curto prazo é limitada pelo contexto, então precisa de uma estratégia.
Um ponto importante: o contexto que vai para o modelo é a soma da memória de curto prazo com o que foi recuperado da memória de longo prazo. Se você reserva 30% do contexto para informação recuperada, sobra no máximo 70% para a memória de curto prazo. Quando esse limite é atingido, o excesso vai para a memória de longo prazo.
Estratégias de remoção
Gerenciar memória não é novidade, todo sistema de dados faz isso. A estratégia mais simples é a FIFO (primeiro a entrar, primeiro a sair): o que entrou primeiro no contexto é o primeiro a sair. Provedores de API podem começar a cortar o início de conversas longas, e frameworks como o LangChain permitem manter só as últimas N mensagens ou os últimos N tokens.
O problema é que essa estratégia assume que o começo da conversa importa menos, e isso pode estar muito errado. Muitas vezes as primeiras mensagens são justamente as que dizem qual é o objetivo da conversa. FIFO é simples, mas pode fazer o modelo perder o fio da meada.
Estratégias mais sofisticadas removem a redundância. A linguagem humana repete bastante coisa para ficar clara e evitar mal-entendidos. Se você conseguir detectar essa redundância automaticamente, o espaço ocupado na memória cai muito.
Uma forma de remover redundância é usar um resumo da conversa, gerado pelo mesmo modelo ou por outro. Resumo junto com o rastreamento de entidades nomeadas (pessoas, lugares, produtos citados) já leva você bem longe.
Ajuste fino
Para fechar a parte de agentes, vale entender o ajuste fino, que apareceu algumas vezes como solução.
Ajuste fino (fine-tuning) é adaptar um modelo a uma tarefa específica treinando de novo o modelo inteiro ou parte dele.
Ele pode melhorar a capacidade do modelo num domínio, como programação ou perguntas médicas, e também reforçar a segurança. Mas o uso mais comum é melhorar a capacidade de seguir instruções, principalmente para o modelo respeitar um estilo ou formato de saída.
Você começa com um modelo base que já tem parte do que precisa, e o ajuste fino leva esse modelo até um desempenho bom o suficiente para a sua tarefa.
Aprendizado por transferência
O ajuste fino é uma forma de aprendizado por transferência, uma ideia de 1976: usar o que foi aprendido numa tarefa para aprender mais rápido uma tarefa parecida. É o que acontece com a gente: quem toca piano aprende outro instrumento com mais facilidade.
Isso melhora a eficiência de amostras, ou seja, o modelo aprende o mesmo comportamento com menos exemplos. Treinar um modelo do zero para responder perguntas jurídicas pode exigir milhões de exemplos. Fazer ajuste fino de um bom modelo base pode exigir só algumas centenas.
O ideal é que quase tudo que o modelo precisa já esteja no modelo base, e o ajuste fino só refine o comportamento. A OpenAI, no artigo do InstructGPT, sugere pensar no ajuste fino como uma forma de destravar capacidades que o modelo já tem, mas que são difíceis de acessar só com prompt.
Referência
Este artigo faz parte dos meus estudos sobre engenharia de IA, baseados no livro AI Engineering: Building Applications with Foundation Models, de Chip Huyen (O'Reilly, 2025). As imagens usadas aqui também vêm do livro.