Escolhendo um modelo: API, código aberto e benchmarks
Como escolher um modelo para a sua aplicação: API ou hospedagem própria, rankings públicos e o problema da contaminação de benchmarks.
Série · Parte 7 de 14 Engenharia de IA
- 01 De Sherlock ao GPT: a estatística por trás da linguagem 7 min
- 02 O que existe dentro de um modelo base 9 min
- 03 Parâmetros, computação e os limites da escala 8 min
- 04 Pós-treinamento e amostragem: por que a IA responde diferente a cada vez 9 min
- 05 Como medir um modelo: entropia, perplexidade e IA como juiz 10 min
- 06 Critérios de avaliação: sua IA realmente ajuda o negócio? 6 min
- 07 Escolhendo um modelo: API, código aberto e benchmarks 10 min
- 08 Do pipeline de avaliação ao primeiro prompt 11 min
- 09 Boas práticas de engenharia de prompt 9 min
- 10 RAG: dando contexto ao modelo 13 min
- 11 RAG na prática: otimizando a recuperação 9 min
- 12 Agentes: ferramentas e planejamento 13 min
- 13 Agentes: execução, falhas e memória 12 min
- 14 Arquitetura de uma aplicação de IA 11 min
Neste artigo15 seções
- Atributos rígidos e flexíveis
- Fluxo de seleção
- Comprar ou hospedar
- Código aberto, peso aberto e licenças
- APIs de modelos
- Privacidade dos dados
- Linhagem dos dados e direitos autorais
- Controle, acesso e transparência
- Benchmarks
- Os rankings públicos
- O problema da média
- Monte o seu próprio ranking
- Contaminação de benchmarks
- Como detectar
- Referência
No fim das contas, você não quer saber qual é o melhor modelo do mundo. Você quer saber qual é o melhor modelo para a sua aplicação. Depois de definir os critérios de avaliação, é com eles que você compara os candidatos.
E essa escolha não acontece uma vez só. Ao longo do desenvolvimento, conforme você testa técnicas diferentes, vai escolher modelo várias vezes. Um caminho comum é começar a engenharia de prompt com o modelo mais forte disponível, para ver se a ideia é viável, e depois ir descendo para modelos menores até achar o limite. Se for fazer ajuste fino, o caminho costuma ser o inverso: começar pequeno para testar o código e ir subindo até o maior modelo que cabe no seu hardware.
Atributos rígidos e flexíveis
Ao analisar modelos, separe dois tipos de atributo:
- Rígidos: o que você não consegue ou não pode mudar. Geralmente vêm de decisões do provedor (licença, dados de treinamento, tamanho do modelo) ou das suas próprias políticas (privacidade, controle). Em alguns casos, eles sozinhos já eliminam boa parte das opções.
- Flexíveis: o que dá para melhorar, como precisão, toxicidade ou consistência factual.
Estimar o quanto um atributo flexível pode melhorar é um equilíbrio entre otimismo e realismo. Um modelo pode começar com 20% de acerto e saltar para 70% só de quebrar a tarefa em duas etapas. E outro pode continuar inutilizável depois de semanas de ajuste, até você desistir dele.
Fluxo de seleção
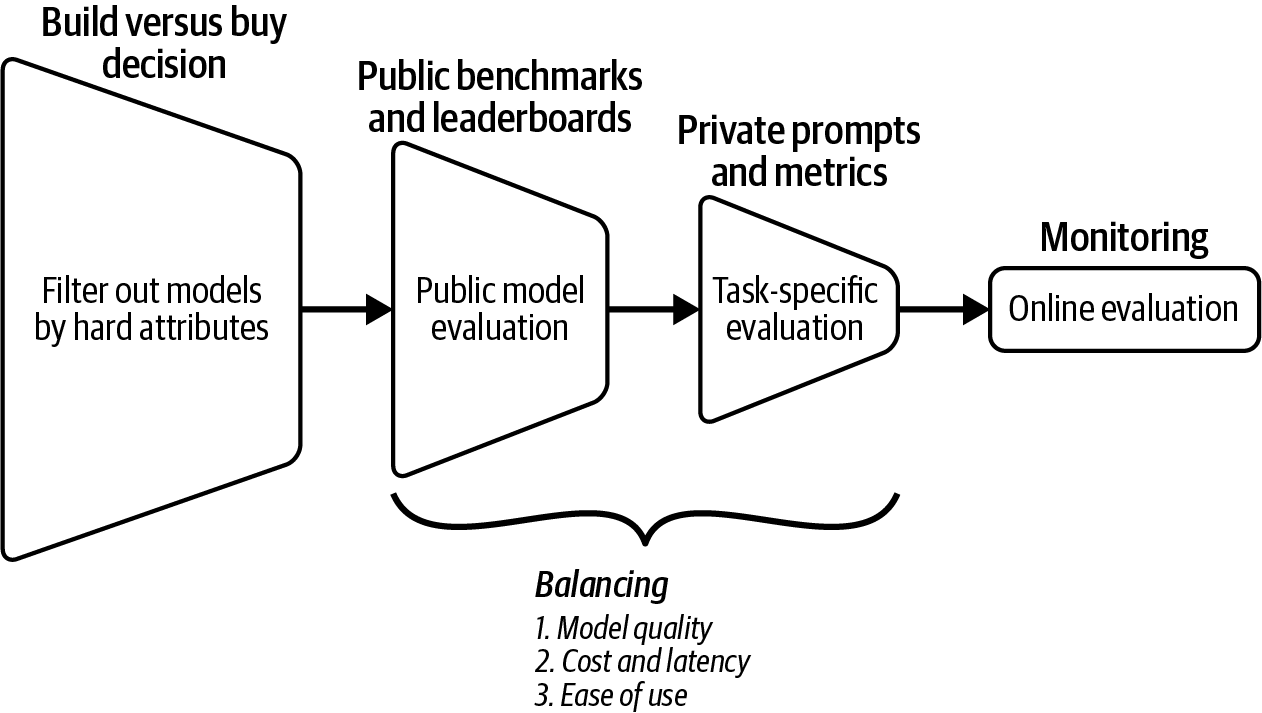
- Filtre os modelos cujos atributos rígidos não servem para você. Isso depende muito das suas políticas internas e de você querer usar API comercial ou hospedar o próprio modelo.
- Use informações públicas, como benchmarks e rankings, para chegar aos candidatos mais promissores, equilibrando qualidade, latência e custo.
- Rode experimentos com o seu próprio pipeline de avaliação para encontrar o melhor, de novo equilibrando esses objetivos.
- Monitore o modelo em produção para detectar falhas e coletar feedback.
Comprar ou hospedar
Toda empresa, com qualquer tecnologia, se pergunta se deve construir ou comprar. Como quase ninguém vai treinar um modelo de base do zero, a pergunta vira: usar uma API comercial ou hospedar um modelo aberto? A resposta já corta bastante a lista de candidatos.
Código aberto, peso aberto e licenças
O termo "modelo de código aberto" virou polêmica. No começo, ele era usado para qualquer modelo que você pudesse baixar e usar. Para muitos casos, isso basta.
Mas tem quem defenda que, como o desempenho do modelo depende muito dos dados de treinamento, ele só deveria ser chamado de aberto se os dados também forem públicos. Por isso surgiu a distinção entre modelos de código aberto e modelos de peso aberto (você baixa os pesos, mas não sabe com o que foram treinados).
Dados abertos permitem retreinar o modelo do zero com mudanças na arquitetura, no processo ou nos próprios dados. Também facilitam entender o modelo e, em alguns casos, são exigidos para auditoria, para garantir que ele não foi treinado com dados obtidos de forma ilegal.
APIs de modelos
O serviço que hospeda o modelo, recebe as consultas, executa o modelo e devolve as respostas se chama serviço de inferência. A interface que o usuário usa para falar com ele é a API do modelo.
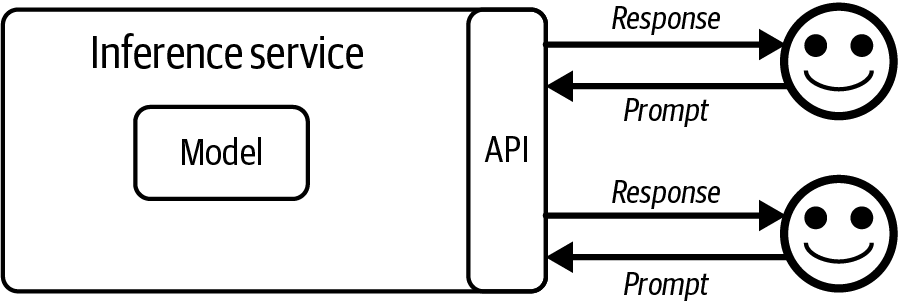
Existem também APIs para outros serviços, como ajuste fino e avaliação, mas quando se fala em "API de modelo" normalmente é a de inferência.
Quem desenvolve um modelo pode abrir o código, oferecer por API ou os dois. Cohere e Mistral abrem alguns modelos e vendem acesso a outros por API. A OpenAI é conhecida pelos modelos comerciais, mas já abriu alguns, como GPT-2 e CLIP. Em geral, os provedores abrem os modelos mais fracos e deixam os melhores atrás de um paywall.
A decisão entre hospedar e usar API depende do caso de uso, e pode mudar com o tempo. Os principais eixos para pensar são: privacidade, linhagem dos dados, desempenho, funcionalidades, custo, controle e execução no dispositivo. Vou passar pelos que mais pesam.
Privacidade dos dados
Para empresas com políticas rígidas que proíbem enviar dados para fora da organização, APIs externas estão fora de questão.
Um dos casos mais conhecidos foi o de funcionários da Samsung que colaram informações internas no ChatGPT e acabaram vazando segredos da empresa.
Nesse cenário, quando é necessário trabalhar com informações sensíveis, um modelo hospedado internamente entra como solução para não expor esses dados a um provedor externo.
Linhagem dos dados e direitos autorais
A preocupação com a origem dos dados e com direitos autorais pode puxar uma empresa para modelos abertos, para modelos proprietários ou para os dois.
Na maioria dos modelos, há pouca transparência sobre os dados de treinamento. Relatórios técnicos de grandes modelos costumam detalhar o desempenho e falar quase nada sobre os dados. Isso levou algumas empresas a preferirem modelos totalmente abertos, com dados públicos, para que a comunidade possa inspecioná-los. Na teoria é ótimo, mas na prática é muito difícil para qualquer empresa revisar um conjunto de dados desse tamanho.
Controle, acesso e transparência
Uma pesquisa de 2024 da a16z mostrou que os dois principais motivos para empresas olharem para modelos abertos são controle e personalização.
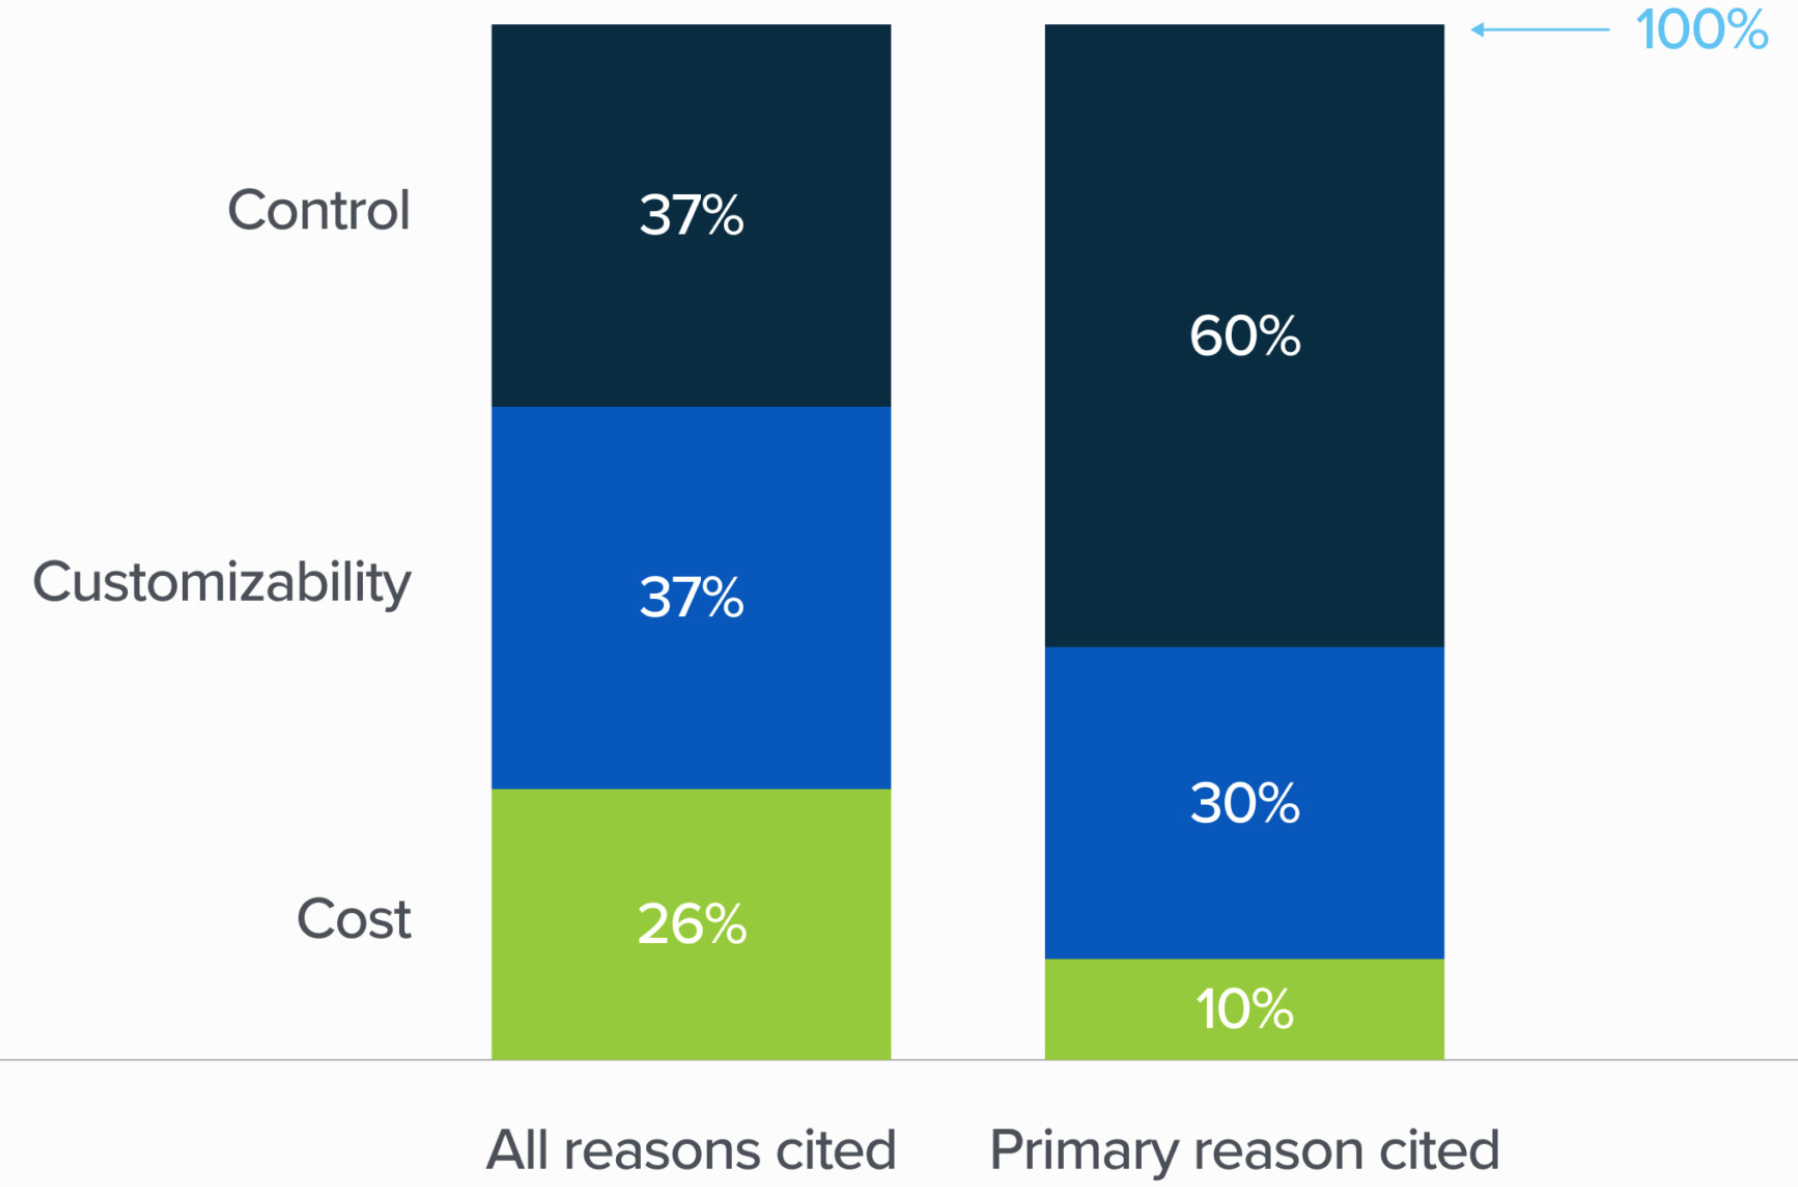
Se o seu negócio depende de um modelo, é natural querer controle sobre ele. Usando o serviço de outra empresa, você fica sujeito aos termos de uso, aos limites de requisição e ao que ela decidir liberar.
Os provedores também colocam barreiras de segurança para se proteger e proteger os usuários, como bloquear piadas racistas ou a geração de fotos de pessoas reais. Modelos proprietários tendem a errar pelo excesso de censura. Para a maioria dos casos isso é bom, mas pode atrapalhar alguns. Se a sua aplicação precisa gerar rostos realistas para um videoclipe, um modelo que se recusa a fazer isso não serve.
Um exemplo bem ilustrativo: uma empresa que cria personagens de IA em ambientes 3D, capazes até de pegar objetos, esbarrava em modelos comerciais que insistiam em responder "como um modelo de IA, não tenho habilidades físicas". A solução foi fazer ajuste fino em um modelo aberto.
Benchmarks
Uma ferramenta que roda um modelo contra vários benchmarks de uma vez é chamada de harness de avaliação. O lm-evaluation-harness da EleutherAI suporta centenas de benchmarks, e o evals da OpenAI permite rodar centenas deles e registrar novos. Eles cobrem de matemática e quebra-cabeças até identificar palavras desenhadas em arte ASCII.
Juntar os resultados de vários benchmarks para ranquear modelos gera um ranking (leaderboard). E aí aparecem duas perguntas:
- Quais benchmarks entram no ranking?
- Como combinar os resultados?
Os rankings públicos
Como existem milhares de benchmarks, é impossível olhar todos. Se o modelo A é melhor em um benchmark de código, mas pior em um de toxicidade, qual você escolhe? E se ele é melhor em um benchmark de código e pior em outro benchmark de código?
Os rankings públicos usam um subconjunto de benchmarks. São úteis, mas estão longe de ser completos. Rodar benchmark custa computação, então alguns importantes ficam de fora por serem caros.
No fim de 2023, por exemplo, o ranking Open LLM da Hugging Face usava a média de seis benchmarks:
- ARC-C: questões de ciências de nível escolar que exigem raciocínio.
- MMLU: conhecimento e raciocínio em 57 disciplinas, como matemática, história, computação e direito.
- HellaSwag: prever o final de uma frase ou cena, testando senso comum.
- TruthfulQA: gerar respostas verdadeiras e que não enganam.
- WinoGrande: resolver pronomes ambíguos que exigem raciocínio de senso comum.
- GSM-8K: problemas de matemática do ensino fundamental.
Faz sentido em alto nível, mas não fica claro por que seis e não dez, ou por que não há testes de resumo, uso de ferramentas ou toxicidade. Não é uma crítica a esses rankings, é só um sinal de como é difícil escolher os benchmarks.
O problema da média
A Hugging Face calculava a média simples das notas. Isso trata todos os benchmarks como iguais: 80% no TruthfulQA vale o mesmo que 80% no GSM-8K, mesmo que um seja muito mais difícil que o outro. E dá o mesmo peso para todos, mesmo que na sua aplicação ser verdadeiro importe muito mais que resolver contas.
Nem todo modelo tem nota pública em todos os benchmarks. Se o seu candidato não tem, você mesmo vai precisar rodar, e isso custa caro. Stanford gastou algo entre US$ 80 mil e US$ 100 mil para avaliar 30 modelos no conjunto completo do HELM.
Monte o seu próprio ranking
Rankings públicos dão uma noção geral, mas um modelo bem colocado neles nem sempre vai bem na sua aplicação. Se você precisa de geração de código e o ranking não tem benchmark de código, ele ajuda pouco.
Na prática, avaliar modelos para uma aplicação é montar um ranking privado com os seus critérios:
- reúna benchmarks que medem as capacidades que importam para você (código para um agente de programação, escrita criativa para um assistente de redação);
- prefira benchmarks recentes, porque os antigos ficam saturados rápido;
- confira se o benchmark é confiável, já que qualquer pessoa pode publicar um e nem todos medem o que dizem medir.
Contaminação de benchmarks
A contaminação de dados acontece quando o modelo foi treinado com os mesmos dados usados para avaliá-lo. Aí ele pode simplesmente ter decorado as respostas e tirar uma nota maior do que merece. Um modelo treinado no MMLU pode ir muito bem no MMLU e não servir para nada.
Um artigo satírico de 2023, "Pretraining on the Test Set Is All You Need", mostrou isso muito bem: um modelo de apenas um milhão de parâmetros, treinado só com dados de benchmarks, tirou notas quase perfeitas e superou modelos muito maiores.
Como muitos modelos são treinados com dados da internet, é fácil que benchmarks públicos acabem entrando no treinamento sem querer. Esse é um dos motivos de os benchmarks ficarem saturados tão rápido e de cada novo modelo vir com benchmarks novos.
A contaminação também pode ser indireta. Você coloca livros de matemática no treinamento para melhorar o modelo em matemática, e outra pessoa usa questões desses mesmos livros para criar um benchmark.
Na prática, o fato de um modelo passar no exame da OAB não quer dizer que ele dá boa consultoria jurídica. Ele pode só ter visto muitas questões do exame.
Como detectar
Primeiro é preciso detectar a contaminação, depois limpar os dados. As duas heurísticas mais usadas são:
- Sobreposição de n-gramas: se uma sequência de, por exemplo, 13 tokens de uma amostra de avaliação também aparece nos dados de treinamento, o modelo provavelmente viu aquela amostra. Ela é considerada suja. É mais precisa, mas cara e lenta, porque compara cada exemplo com todo o conjunto de treinamento, e impossível sem acesso aos dados.
- Perplexidade: se a perplexidade do modelo nos dados de avaliação é baixa demais, ou seja, ele prevê o texto com muita facilidade, é possível que já tenha visto esse texto. É menos precisa, mas muito mais barata.
Escolher o modelo é só uma parte. O passo seguinte é montar um pipeline de avaliação que acompanhe a aplicação inteira, do primeiro prompt à produção.
Referência
Este artigo faz parte dos meus estudos sobre engenharia de IA, baseados no livro AI Engineering: Building Applications with Foundation Models, de Chip Huyen (O'Reilly, 2025). As imagens usadas aqui também vêm do livro.